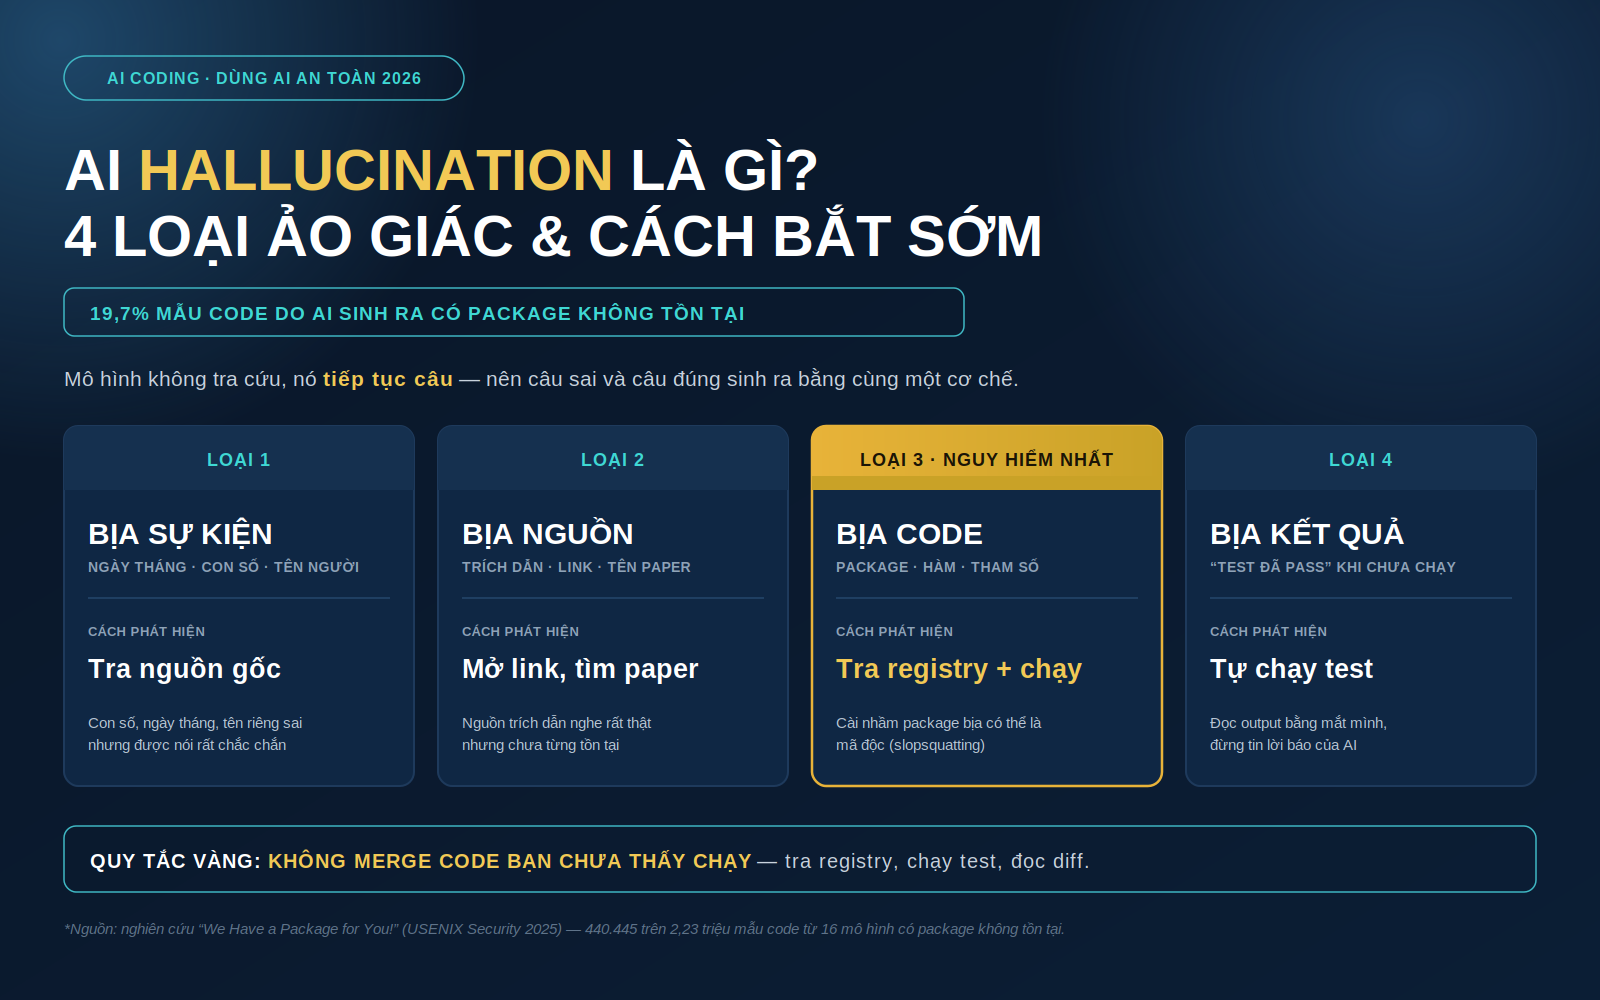
AI hallucination là gì? AI hallucination (ảo giác AI) là hiện tượng mô hình ngôn ngữ tạo ra thông tin nghe rất chắc chắn nhưng sai hoặc không tồn tại: sự kiện bịa, trích dẫn bịa, thư viện chưa từng được ai viết. Đây không phải lỗi hiếm gặp. Nó là hệ quả tự nhiên của cách LLM hoạt động.
AI Hallucination là gì? Cách nhận biết
Bài này viết cho sinh viên IT và lập trình viên mới dùng AI để học và viết code. Bạn sẽ hiểu cơ chế gây ra hallucination, biết nó nguy hiểm ở đâu, và có quy trình kiểm tra dùng được ngay.
AI hallucination là gì? Định nghĩa dễ hiểu cho người mới
Hãy nhớ một câu: mô hình không tra cứu, nó tiếp tục câu hỏi tên một hàm ít gặp, nó không mở tài liệu mà tạo chuỗi ký tự nghe giống tên hàm thật.
Vì vậy, câu trả lời sai và câu trả lời đúng được sinh ra bằng cùng một cơ chế. Mô hình không có cách tự biết mình đang bịa.
So sánh đời thường: học sinh đi thi trắc nghiệm
Hãy tưởng tượng một kỳ thi chấm theo số câu đúng. Để trống được 0 điểm, đoán bừa thì vẫn có cơ hội.
Trong hệ thống đó, học sinh thông minh nào cũng đoán bừa khi không biết — không phải vì thiếu trung thực, mà vì cách chấm điểm khen hành vi đó. LLM được đánh giá trong đúng bối cảnh như vậy.
Hallucination khác bug lập trình thông thường ở đâu
Điểm khác biệt nằm ở tính lặp lại. Một bug cho cùng kết quả sai với cùng đầu vào, nên bạn tái hiện được. Hallucination mang tính xác suất: chạy lại cùng prompt có thể ra câu khác.
Ngoài ra, bug thường báo lỗi. Hallucination thì trông bình thường — code đúng cú pháp, chú thích hợp lý, chỉ có điều hàm đó không tồn tại.
Bốn loại AI hallucination bạn sẽ gặp
| Loại | Biểu hiện | Cách phát hiện |
|---|---|---|
| Bịa sự kiện | Ngày tháng, con số, tên người sai | Tra nguồn gốc |
| Bịa nguồn | Trích dẫn, link, tên paper không tồn tại | Mở link, tìm tên paper |
| Bịa code | Package, hàm, tham số không có thật | Tra registry, chạy thử |
| Bịa kết quả | Khẳng định “test đã pass” khi chưa chạy | Tự chạy test |
Vì sao AI hallucination xảy ra? Giải thích từ cách LLM hoạt động
Có bốn nguyên nhân, và chúng cộng dồn.
Nguyên nhân 1 — LLM là máy dự đoán token
LLM học một việc duy nhất: đoán token tiếp theo trong chuỗi. Nó tối ưu cho việc trông có vẻ đúng, không phải đúng sự thật. Chi tiết về cơ chế, bạn có thể xem thêm bài viết giải thích LLM là gì.
Nguyên nhân 2 — Có những sự thật không thể học bằng quy luật
Cú pháp Python có quy luật, nên mô hình học rất tốt. Nhưng ngày sinh của một người, hay tên chính xác của một hàm trong thư viện ít dùng, là thông tin tùy ý — không quy luật nào suy ra được. Với loại này, mô hình chỉ còn cách nội suy từ những cái tên tương tự. Đó là lúc nó bịa.
Nguyên nhân 3 — Cách chấm điểm thưởng cho việc đoán bừa
Đây là phần thú vị nhất, và ít được nhắc tới ở tài liệu tiếng Việt. Tháng 9/2025, OpenAI công bố nghiên cứu Why language models hallucinate. Luận điểm chính: các benchmark phổ biến chấm theo độ chính xác thuần, nên nói “tôi không biết” bị trừ điểm nặng hơn đoán sai.
Bảng dưới đây là bằng chứng rõ ràng, đo trên bộ SimpleQA:
| Chỉ số | gpt-5-thinking-mini | o4-mini |
|---|---|---|
| Tỷ lệ từ chối trả lời | 52% | 1% |
| Tỷ lệ đúng | 22% | 24% |
| Tỷ lệ sai | 26% | 75% |
Hãy đọc kỹ bảng. Mô hình o4-mini đúng hơn 2 điểm phần trăm, nhưng tỷ lệ sai cao gần ba lần, vì nó gần như không bao giờ từ chối trả lời. Bài học: điểm benchmark cao không có nghĩa là ít bịa hơn.
Nguyên nhân 4 — Ngữ cảnh bạn cung cấp
Prompt mơ hồ, ngữ cảnh quá dài, hoặc câu hỏi chứa giả định sai đều làm hallucination tăng. Ví dụ: nếu bạn hỏi “hàm parse_config_v2 trong thư viện X dùng thế nào”, mô hình sẽ nương theo giả định rằng hàm đó tồn tại.
Ví dụ AI hallucination: ngoài đời và khi bạn viết code
Hãy xem AI hallucination là gì trong thực tế, qua những trường hợp cụ thể.
Hai vụ việc nổi tiếng
Năm 2023, trong vụ Mata kiện Avianca tại Mỹ, luật sư nộp lên tòa các án lệ do ChatGPT tạo ra. Những án lệ đó không tồn tại. Sau đó vụ việc thành ví dụ kinh điển.
Cũng năm 2023, một chatbot AI trả lời sai về thành tựu của kính viễn vọng James Webb ngay trong video quảng bá chính thức. Bạn có thể tìm hiểu thêm thông tin về các ví dụ kinh điển này.
Ba tình huống bạn gặp khi code
Tình huống 1 — import package không tồn tại. AI gợi ý pip install fastapi-auth-utils. Lệnh báo lỗi không tìm thấy, hoặc tệ hơn, tải về một package lạ của ai đó. Cách phát hiện: tra tên trên PyPI hoặc npm trước khi cài.
Tình huống 2 — gọi hàm với tham số không có trong tài liệu. AI viết df.to_csv("out.csv", encoding="utf-8", auto_detect=True). Tham số auto_detect nghe rất hợp lý, nhưng không tồn tại. Cách phát hiện: mở docs chính thức, hoặc chạy và đọc TypeError.
Tình huống 3 — AI khẳng định đã chạy test. Trợ lý AI báo “tôi đã chạy test, tất cả pass”. Thực tế nó không chạy gì. Cách phát hiện: tự chạy lệnh test và đọc output bằng mắt mình.
Package hallucination và slopsquatting — rủi ro dev dùng AI phải biết
Khi đã rõ AI hallucination là gì, bạn cần biết mặt nguy hiểm nhất của nó. Phần này gần như chưa có bài tiếng Việt nào nói tới.
Package hallucination là gì?
Nghiên cứu “We Have a Package for You!” tại USENIX Security 2025 đã sinh 2,23 triệu mẫu code từ 16 mô hình. Kết quả: 440.445 mẫu — tức 19,7% — có chứa package không tồn tại, với 205.474 tên package bị bịa ra.
Vài con số đáng chú ý khác từ nghiên cứu này:
- Mô hình mã nguồn mở bịa nhiều hơn: trung bình 21,7%, so với 5,2% ở mô hình thương mại.
- 43% tên package bịa xuất hiện lại ở mọi lần chạy; 58% xuất hiện lại ở nhiều lần chạy.
- Về bản chất, 51% là bịa hoàn toàn, 38% là nhầm lẫn giữa hai package thật, 13% là sai chính tả.
Tính lặp lại khiến vấn đề nghiêm trọng hơn. Nếu AI bịa tên ngẫu nhiên mỗi lần, kẻ tấn công không làm gì được. Nhưng khi cùng một tên lặp lại đều đặn, nó thành mục tiêu.
Slopsquatting là gì?
Slopsquatting là kiểu tấn công chuỗi cung ứng mới: kẻ tấn công đăng ký trước những tên package mà AI thường bịa, rồi nhét mã độc vào đó. Khác với typosquatting (lợi dụng người gõ sai), slopsquatting lợi dụng chính AI.
Theo research note về slopsquatting của Cloud Security Alliance công bố tháng 4/2026, đã có vụ việc thật:
huggingface-cli— một tên bịa, nhưng đạt hơn 30.000 lượt tải.react-codeshift— lan qua 237 repository thông qua các bộ hướng dẫn do AI sinh.
Một nghiên cứu đánh giá lại trên mô hình đời 2026 (khảo sát 22–28/4/2026) cho thấy tỷ lệ đã giảm rõ: Claude Haiku 4.5 ở mức 4,62%, Claude Sonnet 4.6 5,41%, Gemini 2.5 Pro 5,80%, GPT-5.4-mini 6,10%.
Tuy nhiên, 4,62% vẫn đủ để tấn công có lãi. Nghiên cứu ghi nhận 53 tên package bị mọi mô hình bịa vẫn còn trống trên PyPI và npm.
Vì sao AI agent làm rủi ro lớn hơn
Trước đây bạn copy lệnh pip install rồi tự chạy, nên có một nhịp để nhìn. Các agent hiện nay tự chạy lệnh cài đặt, nên package bịa có thể vào máy trước khi bạn kịp đọc tên nó. Hãy cấu hình allowlist cho agent và đọc diff trước khi chấp nhận.
CTA giữa bài: Muốn dùng AI viết code đúng cách, có mentor review từng commit? Xem khóa học AI Coding tại CodeGym Đà Nẵng.
Tỷ lệ hallucination của các model AI năm 2026 — đọc benchmark thế nào
Câu hỏi “model nào ít bịa nhất” nghe đơn giản, nhưng không có con số duy nhất. Mỗi benchmark đo một việc khác.
- Vectara HHEM đo mức trung thành khi tóm tắt một tài liệu cho trước. Điểm thấp là tốt.
- SimpleQA và AA-Omniscience đo kiến thức và mức dám nói “không biết”.
- Các bộ đo khác nhắm vào hội thoại dài hoặc suy luận.
Theo số liệu tổng hợp công khai, bảng HHEM cập nhật tháng 5/2026 cho thấy GPT-5.4 Mini ở mức khoảng 5,5%, DeepSeek V4 Pro 8,6%, GPT-5.5 9,3%, Claude Haiku 4.5 9,8%, Gemini 3.1 Pro 10,4%. Trên AA-Omniscience (6.000 câu hỏi, 42 chủ đề, cập nhật tháng 6/2026), Claude Fable 5 dẫn đầu với chỉ số 40.
Lưu ý quan trọng: đây là số liệu từ nguồn tổng hợp, không phải trang chủ của từng bảng xếp hạng. Trước khi đưa vào báo cáo hay đồ án, hãy mở leaderboard gốc và ghi ngày truy cập.
Hai bài học. Một, chọn model theo tác vụ: tóm tắt tài liệu và trả lời kiến thức là hai bài toán khác nhau. Hai, bật chế độ suy luận không chắc giúp giảm bịa — nhiều ghi nhận cho thấy ngược lại.
5 cách lập trình viên giảm và bắt AI hallucination
Hiểu AI hallucination là gì mới là bước đầu. Bước quan trọng hơn là có quy trình. Bạn không loại bỏ được hallucination, nhưng bạn hạ được xác suất và bắt được nó trước khi code vào nhánh chính.
Cách 1 — Cho AI ngữ cảnh thật
Đừng để mô hình đoán. Hãy dán docs liên quan, code hiện có, file cấu hình. Mô hình có tài liệu trước mắt sẽ bịa ít hơn nhiều.
Khi làm sản phẩm thật, hãy tự động hóa việc này bằng RAG — kỹ thuật tìm tài liệu liên quan rồi nhét vào prompt. Xem bài RAG là gì.
Cách 2 — Viết prompt cho phép AI nói “không biết”
So sánh hai cách hỏi:
- Trước: “Cho tôi thư viện Python để parse file EDI.”
- Sau: “Liệt kê thư viện Python parse EDI mà bạn chắc chắn tồn tại trên PyPI. Nếu không chắc, hãy nói rõ. Không được đoán tên.”
Cách thứ hai cho kết quả ngắn hơn nhưng đáng tin hơn. Thêm kỹ thuật, xem bài prompt engineering là gì.
Cách 3 — Kiểm tra package trước khi cài
Đây là thói quen cần có, chỉ mất 20 giây:
- Tra tên package trên npm hoặc PyPI. Không có là bịa.
- Xem ngày phát hành đầu tiên và số lượt tải. Mới tạo mà AI đã “biết” là dấu hiệu rất xấu.
- Mở repository gốc, kiểm tra có mã nguồn thật không.
- Dùng lockfile kèm hash để lần cài sau không đổi nội dung.
- Với agent, cấu hình allowlist để nó không tự cài tùy ý.
Cách 4 — Chạy thật, đừng tin lời AI
Test, linter và type checker là máy phát hiện bịa miễn phí. Hàm không tồn tại chết ở bước import; tham số bịa chết ở TypeError. Hãy đặt ngưỡng: không merge đoạn code nào bạn chưa thấy chạy.
Cách 5 — Human-in-the-loop
AI đề xuất, con người quyết định. Hãy đọc diff từng dòng, nhất là phần thay đổi dependency. Nếu công việc cần chính xác cao, hạ temperature xuống gần 0.
Các công cụ AI coding hiện nay đều cho xem diff trước khi áp dụng — ví dụ Claude Code. Hãy dùng tính năng đó, đừng bấm “accept all” theo quán tính.
Nếu bạn không phải lập trình viên — 3 thói quen dùng AI an toàn
Bạn không viết code nhưng vẫn cần biết AI hallucination là gì. Nếu dùng AI để viết email, tóm tắt tài liệu hay tra thông tin, ba thói quen sau là đủ.
Một: luôn kiểm tra lại con số, ngày tháng và tên riêng — ba thứ AI bịa nhiều nhất.
Hai: yêu cầu AI nêu nguồn, rồi tự mở link. Link không mở được thì rất có thể nguồn không tồn tại.
Ba: đừng dùng AI làm nguồn duy nhất cho quyết định quan trọng. Hãy coi nó như đồng nghiệp nhanh nhẹn nhưng hay nhớ sai.
Câu hỏi thường gặp về AI hallucination
AI hallucination có phải là AI nói dối không?
Không. Nói dối đòi hỏi biết sự thật và cố ý nói khác đi. LLM không có khái niệm đúng sai; nó chỉ tạo chuỗi token có xác suất cao. Khi bịa, mô hình “tin” câu trả lời của mình hệt như khi nói đúng. Vì vậy, hỏi “bạn có chắc không” thường không giúp được gì.
Có thể loại bỏ hoàn toàn AI hallucination không?
Không, ít nhất với kiến trúc hiện nay. Hallucination xuất phát từ bản chất dự đoán xác suất và từ việc có những sự thật không thể suy ra bằng quy luật. Bạn chỉ giảm được tần suất: cấp ngữ cảnh thật, dùng RAG, cho phép mô hình nói không biết, và luôn chạy thử kết quả.
Model AI nào ít hallucination nhất hiện nay?
Không có câu trả lời cố định, vì mỗi benchmark đo một việc khác. Một model dẫn đầu về tóm tắt trung thành có thể bịa nhiều khi trả lời câu hỏi kiến thức. Cách đúng là mở leaderboard gốc như Vectara HHEM hoặc AA-Omniscience đúng thời điểm, rồi chọn theo tác vụ của bạn.
Copilot hoặc Cursor gợi ý thư viện không tồn tại thì phải làm gì?
Đừng cài ngay. Hãy tra tên đó trên npm hoặc PyPI trước. Nếu không có, hãy hỏi lại AI kèm yêu cầu chỉ nêu thư viện chắc chắn tồn tại. Nếu có nhưng mới tạo gần đây và rất ít lượt tải, hãy cảnh giác: đó có thể là package slopsquatting.
Slopsquatting là gì và có nguy hiểm với sinh viên không?
Slopsquatting là việc kẻ tấn công đăng ký sẵn những tên package mà AI thường bịa, rồi nhét mã độc vào. Sinh viên hoàn toàn nằm trong tầm ngắm, vì đồ án thường cài thư viện nhanh và không đọc kỹ. Thói quen tra registry trước khi cài là cách phòng vệ đơn giản nhất.
Temperature thấp có giúp AI bớt bịa không?
Có phần, nhưng không giải quyết gốc rễ. Hạ temperature làm câu trả lời ổn định và ít sáng tạo hơn, nên giảm bịa trong nhiều trường hợp. Tuy nhiên, nếu mô hình vốn không biết câu trả lời, nó vẫn bịa — chỉ là bịa một cách nhất quán hơn.
RAG có chấm dứt hallucination không?
Không chấm dứt, nhưng giảm rõ rệt. RAG đưa tài liệu thật vào ngữ cảnh, nên mô hình có cái để dựa vào thay vì đoán. Dù vậy, mô hình vẫn có thể hiểu sai tài liệu hoặc trộn thông tin từ nhiều đoạn. Hãy luôn yêu cầu trích dẫn đoạn nguồn để kiểm tra lại.
Dùng AI để học lập trình có an toàn không nếu nó hay bịa?
An toàn, nếu bạn luôn chạy thử. Thực tế, việc AI bịa lại là bài tập tốt: nó buộc bạn đọc tài liệu gốc và kiểm chứng. Hãy đặt quy tắc không copy đoạn code nào mà bạn chưa chạy và chưa hiểu. Kỹ năng review output của AI đang là kỹ năng nghề quan trọng.
Kết luận: AI hallucination là gì và bạn cần làm gì
Ba ý cần mang theo. Thứ nhất, hallucination là bản chất của LLM, không phải bug sẽ được vá. Thứ hai, bạn không cần sợ AI, bạn cần quy trình kiểm tra: tra registry, chạy test, đọc diff. Thứ ba, kỹ năng review kết quả của AI đang thành kỹ năng nghề.
Bước tiếp theo: lần tới khi AI gợi ý một thư viện, hãy tra tên nó trên PyPI hoặc npm trước khi cài. Muốn hiểu bức tranh lớn hơn, đọc bài AI coding là gì.
CTA cuối bài: Muốn học AI Coding bài bản, có mentor review code và chỉ ra chỗ AI bịa? Xem lộ trình khóa học AI Coding tại CodeGym Đà Nẵng hoặc để lại thông tin để được tư vấn miễn phí.
0 Lời bình