LLM là gì? LLM (Large Language Model — mô hình ngôn ngữ lớn) là mạng nơ-ron được huấn luyện trên lượng văn bản khổng lồ để dự đoán token tiếp theo trong một chuỗi. Khả năng dự đoán đó giúp nó sinh văn bản, viết code và trả lời câu hỏi. ChatGPT, Claude hay Gemini không phải LLM; chúng là sản phẩm xây trên LLM.
LLM là gì? Hiểu rõ về LLM
Bài này dành cho sinh viên IT và lập trình viên mới. Bạn sẽ đi từ khái niệm nền tảng đến chỗ tự gọi được một LLM bằng Python.
LLM là gì? Định nghĩa dễ hiểu cho người mới
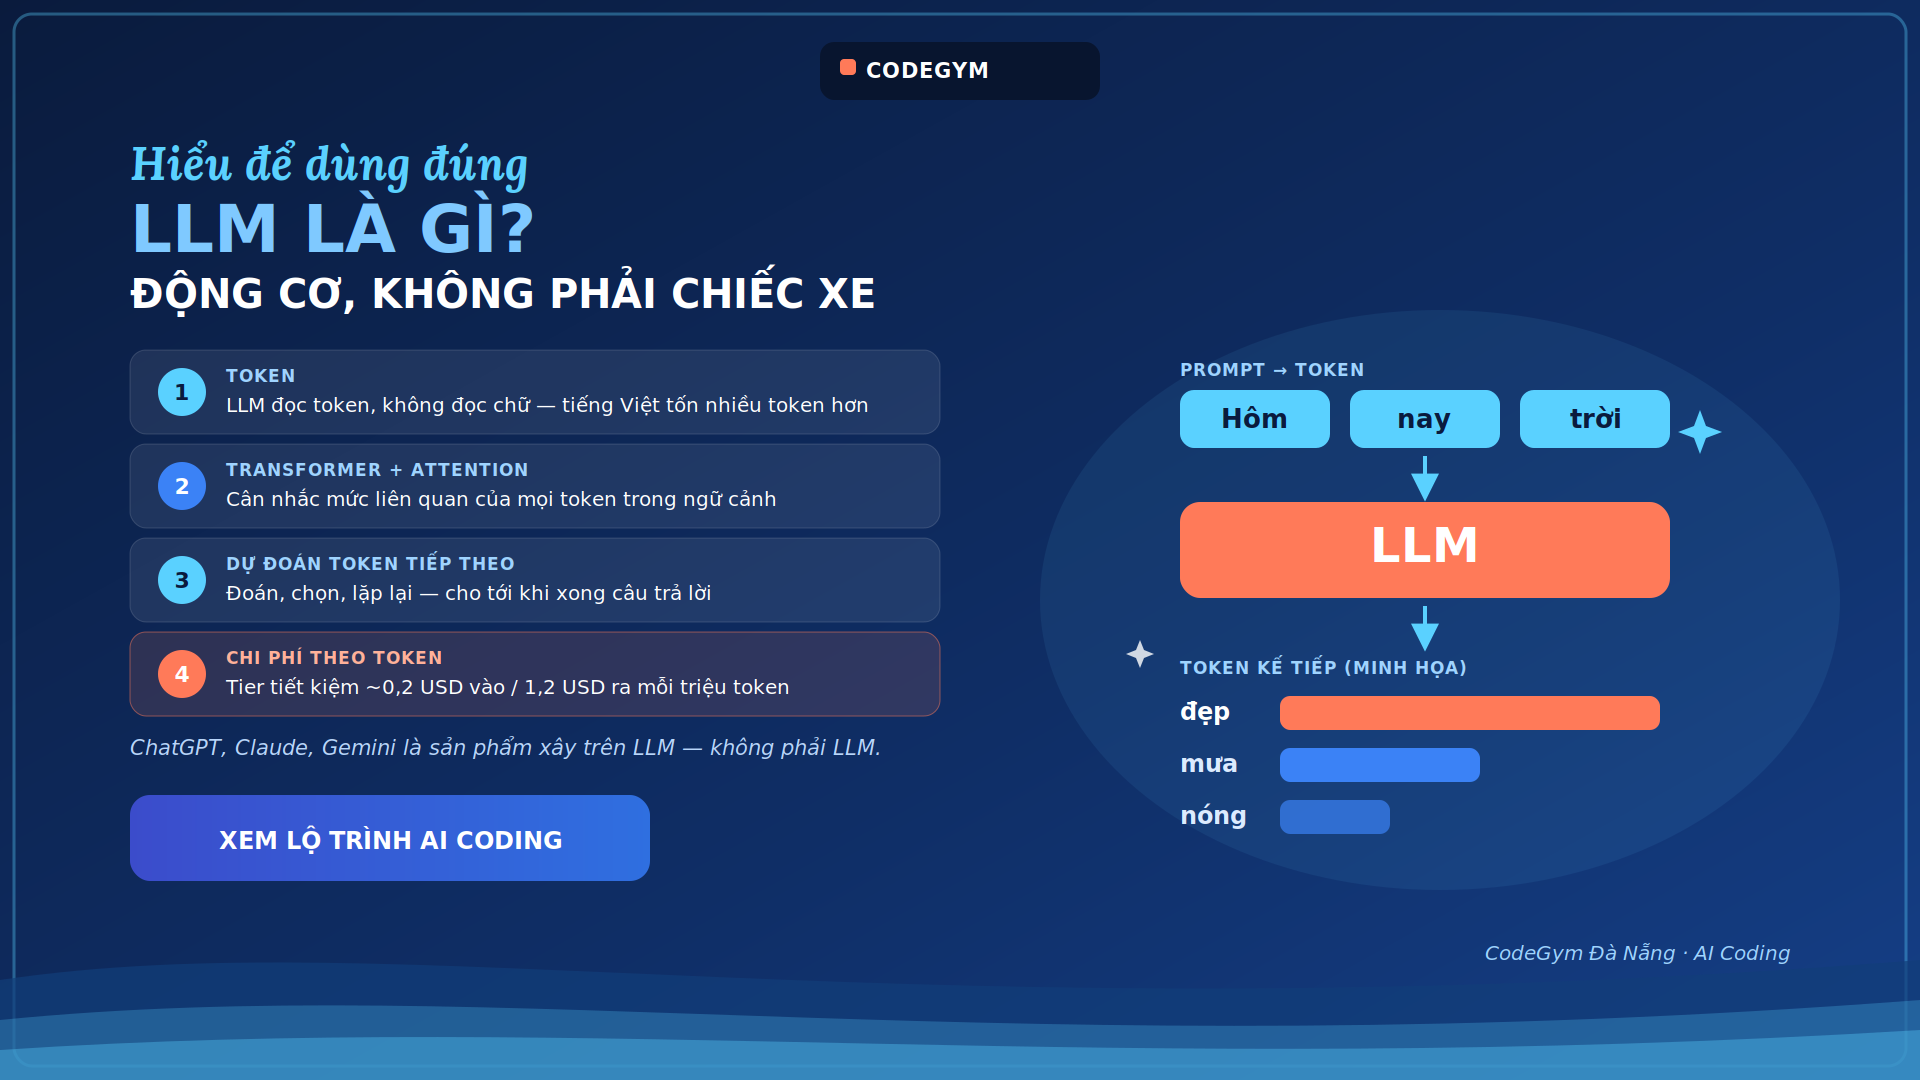
LLM là chương trình dự đoán. Bạn đưa vào một đoạn văn bản, nó trả lời một câu hỏi duy nhất: “token tiếp theo nhiều khả năng là gì?”. Sau đó nó lặp lại hàng nghìn lần để tạo ra cả câu trả lời.
Nghe đơn giản, nhưng quy mô tạo nên khác biệt. Mô hình đọc hàng nghìn tỷ từ và có hàng tỷ tham số. Ở quy mô đó, đoán chữ biến thành khả năng lập luận.
Tách từng chữ: Large — Language — Model
- Large (lớn): lớn về dữ liệu huấn luyện và về số tham số (parameter) mô hình học được.
- Language (ngôn ngữ): đối tượng làm việc là văn bản. Code cũng là văn bản, nên LLM viết được code.
- Model (mô hình): hàm toán học đã nén kinh nghiệm từ dữ liệu.
So sánh đời thường: bộ gõ dự đoán từ, phóng to hàng tỷ lần
Điện thoại của bạn đã có một mô hình ngôn ngữ tí hon. Gõ “Hôm nay trời”, nó gợi ý “đẹp”, “mưa”, “nóng”. Nó chỉ nhìn vài từ phía trước. Mô hình lớn nhìn được cả trăm nghìn từ, nên giữ được mạch của cả một file code dài.
LLM, AI, machine learning, deep learning — ai nằm trong ai?
Bốn thuật ngữ này lồng vào nhau như búp bê Nga. AI là vòng ngoài cùng. Machine learning nằm trong AI. Deep learning nằm trong machine learning. LLM nằm trong deep learning, chuyên xử lý ngôn ngữ. Nói cách khác, mọi LLM đều là AI, nhưng không phải AI nào cũng là LLM.
LLM khác gì ChatGPT, Claude, Gemini?
Đã rõ LLM là gì, câu hỏi tiếp theo hầu như ai cũng vướng. Đây là nhầm lẫn phổ biến nhất. Trả lời ngắn: LLM là động cơ, ChatGPT là chiếc xe. GPT-6 Astra là mô hình. ChatGPT là ứng dụng dùng mô hình đó, kèm giao diện chat và bộ nhớ hội thoại. Là lập trình viên, bạn gọi thẳng mô hình qua API.
| Hãng | Mô hình gần nhất | Sản phẩm | Cách dev truy cập |
|---|---|---|---|
| Anthropic | Claude Fable 5.1 | Claude | Anthropic API |
| OpenAI | GPT-6 Astra, GPT-5.6 Luna | ChatGPT | OpenAI API |
| Gemini 3.8 Flash | Gemini | Gemini API | |
| xAI | Grok 4.7 | Grok | xAI API |
| DeepSeek | DeepSeek-V4.1-Flash | DeepSeek Chat | API hoặc tải về máy |
Lưu ý: bảng này đổi gần như hằng tháng. Hãy mở tài liệu chính thức của hãng trước khi chốt mô hình cho đồ án.
LLM hoạt động như thế nào? Ba khái niệm phải nắm
Token — LLM không đọc chữ, nó đọc token
Token là mẩu văn bản nhỏ mà mô hình thực sự xử lý: một từ, một phần của từ, hoặc một dấu câu.
Điều này quan trọng với người Việt. Bộ tách token tối ưu chủ yếu cho tiếng Anh, nên tiếng Việt có dấu thường bị cắt vụn hơn. Hãy tự kiểm chứng:
# pip install tiktoken
import tiktoken

enc = tiktoken.get_encoding("o200k_base")

cau_en = "The quick brown fox jumps over the lazy dog."
cau_vi = "Con cáo nâu nhanh nhẹn nhảy qua con chó lười biếng."

for ten, cau in [("Tiếng Anh", cau_en), ("Tiếng Việt", cau_vi)]:
    print(f"{ten}: {len(cau)} ký tự -> {len(enc.encode(cau))} token")
Đoạn code nạp bộ tách token, mã hóa hai câu, rồi in số token. Kết quả thường cho thấy câu tiếng Việt tốn nhiều token hơn, nghĩa là prompt tiếng Việt tốn tiền hơn.
Transformer và attention — vì sao mô hình nhớ được ngữ cảnh
Transformer là kiến trúc mạng nơ-ron ra đời năm 2017, trong bài báo Attention Is All You Need. Gần như mọi LLM hiện nay đều dựa trên kiến trúc này.
Ý tưởng cốt lõi tên là attention (cơ chế chú ý). Khi xử lý một token, mô hình cân nhắc mức liên quan của mọi token khác. Ví dụ: “Con mèo đuổi con chuột vì nó đói.” Để biết “nó” chỉ ai, mô hình gán trọng số chú ý cao cho “con mèo”.
Một điểm cần sửa: nhiều tài liệu tiếng Việt cũ mô tả LLM có “lớp recurrent”. Điều đó không đúng — Transformer ra đời để thay thế kiến trúc recurrent (RNN).
Dự đoán token tiếp theo — sao chỉ đoán chữ mà viết được code?
Câu trả lời nằm ở tính kỷ luật của code. Sau def tinh_tong(a, b): gần như chắc chắn là một dòng thụt lề. Để dự đoán tốt trên hàng tỷ dòng code, mô hình buộc phải học cú pháp, quy ước đặt tên và các mẫu thiết kế phổ biến.
Tuy nhiên, hãy nhớ giới hạn. Mô hình tối ưu cho việc trông có vẻ đúng, không phải chạy đúng. Vì vậy code do AI sinh ra luôn cần bạn đọc và chạy test.
Huấn luyện LLM gồm những bước nào?
Biết LLM là gì mới là một nửa. Nửa còn lại là hiểu nó được tạo ra thế nào, vì điều đó giải thích cách nó cư xử.
Pre-training: đọc hàng nghìn tỷ token
Mô hình đọc lượng văn bản khổng lồ từ internet, sách và kho code công khai. Nhiệm vụ duy nhất là che một token rồi đoán nó. Đây là giai đoạn tốn kém nhất, mất hàng tháng trên hàng chục nghìn GPU.
Fine-tuning và RLHF: dạy mô hình làm theo hướng dẫn
Fine-tuning là huấn luyện tiếp trên tập dữ liệu nhỏ, chất lượng cao, gồm các cặp câu hỏi — câu trả lời mẫu. Nhờ đó mô hình biết trả lời thay vì viết tiếp văn bản.
RLHF (Reinforcement Learning from Human Feedback — học tăng cường từ phản hồi của con người) là bước sau. Con người chấm điểm câu trả lời, mô hình học cách tạo câu được chấm cao. Đây là lý do cùng một nền tảng nhưng hai mô hình cư xử rất khác.
Tham số 7B, 70B nghĩa là gì?
B là billion (tỷ). “7B” nghĩa là khoảng 7 tỷ tham số. Con số này ảnh hưởng tới chất lượng lập luận, tốc độ và chi phí phần cứng. Nhưng nhiều mô hình nhỏ huấn luyện tốt vẫn vượt mô hình lớn thế hệ cũ.
LLM là gì khi nhìn qua các con số?
Khi chuyển từ người dùng sang lập trình viên, bạn sẽ gặp vài con số. Đây là những con số bạn chỉnh nhiều nhất.
Context window — mô hình nhìn được bao nhiêu
Context window là lượng token tối đa mô hình xử lý trong một lần gọi, tính cả prompt lẫn câu trả lời. Các mô hình đầu bảng hiện nay thường ở mức khoảng 1 triệu token, tương đương vài nghìn trang sách. Nhưng context không phải bộ nhớ dài hạn: hết phiên là hết. Muốn mô hình nhớ tài liệu riêng, hãy dùng kỹ thuật RAG.
Temperature, max_tokens, system prompt
- temperature: mức ngẫu nhiên. Giá trị thấp (0–0,3) cho câu trả lời ổn định, hợp với code.
- max_tokens: giới hạn độ dài câu trả lời, kiểm soát chi phí.
- system prompt: chỉ dẫn cố định đặt vai trò cho mô hình.
Muốn khai thác ba tham số này, hãy đọc bài prompt engineering là gì.
Chi phí tính theo token
API tính tiền theo token vào và ra, trong đó token ra đắt hơn vài lần. Theo bảng giá tổng hợp cập nhật đầu tháng 9/2026, mô hình đầu bảng như GPT-6 Astra hay Claude Fable 5.1 ở mức khoảng 10 USD mỗi triệu token vào và 50 USD mỗi triệu token ra. Các tier tiết kiệm chỉ khoảng 0,2 USD và 1,2 USD. Vì vậy, một đồ án nhỏ thường tốn dưới vài USD nếu chọn tier rẻ.
Hướng dẫn gọi API LLM bằng Python trong 10 phút
Bước 1: Cài Python và thư viện
python3 --version
python3 -m venv venv
source venv/bin/activate      # Windows: venv\Scripts\activate
pip install anthropic tiktoken
Nếu lệnh đầu báo lỗi, hãy tải Python 3.11 trở lên. Môi trường ảo giữ thư viện của từng dự án tách biệt.
Bước 2: Lấy API key và lưu vào biến môi trường
export ANTHROPIC_API_KEY="sk-ant-..." # Windows: setx ANTHROPIC_API_KEY "sk-ant-..."
Tuyệt đối không viết thẳng API key vào file code. Nếu bạn push lên GitHub, key sẽ bị lộ trong vài phút.
Bước 3: Viết 15 dòng code gửi prompt
import os
import anthropic

client = anthropic.Anthropic(api_key=os.environ["ANTHROPIC_API_KEY"])

response = client.messages.create(
    model=os.environ.get("CLAUDE_MODEL", "claude-fable-5-1"),
    max_tokens=500,
    temperature=0.2,
    system="Bạn là mentor Python. Giải thích bằng tiếng Việt, câu ngắn.",
    messages=[
        {"role": "user", "content": "Vì sao xóa phần tử của list trong vòng for lại lỗi?"}
    ],
)

print(response.content[0].text)
print("Token vào:", response.usage.input_tokens)
print("Token ra:", response.usage.output_tokens)
Giải thích từng phần:
client: kết nối API, đọc key từ biến môi trường.model: tên mô hình, đặt trong biến môi trường để đổi mà không sửa code.max_tokens: chặn trần độ dài câu trả lời.messages: danh sách hội thoại,rolelàuserhoặcassistant.response.usage: số token đã dùng, in ra để theo dõi chi phí.
Bước 4: Đổi temperature và quan sát
Chạy lại với temperature=0.0, rồi temperature=1.0. Ở mức 0, câu trả lời gần như lặp lại y hệt. Ở mức 1, cách diễn đạt thay đổi nhiều. Với bài sinh code, hãy chọn giá trị thấp.
Lỗi thường gặp
- 401 Unauthorized: key sai hoặc biến môi trường chưa nạp. Mở terminal mới rồi thử lại.
- 429 Too Many Requests: hết quota hoặc gọi quá nhanh. Thêm retry có độ trễ tăng dần.
- 404 model not found: tên mô hình đã đổi, hãy tra tài liệu chính thức.
CTA giữa bài: Muốn đi từ đoạn code 15 dòng này tới một ứng dụng AI hoàn chỉnh, có mentor kèm? Tham khảo khóa học AI Coding tại CodeGym Đà Nẵng ngay!
LLM mã nguồn mở và LLM tiếng Việt
Chạy LLM trên laptop bằng Ollama
curl -fsSL https://ollama.com/install.sh | sh
ollama run qwen3:8b
Sau khi tải xong, bạn chat ngay trong terminal. Ollama cũng mở sẵn API cục bộ ở cổng 11434. Số liệu benchmark ở mức nén 4-bit (Q4_K_M) cho thấy nhu cầu bộ nhớ như sau:
| Cỡ mô hình | Bộ nhớ cần | Phù hợp với |
|---|---|---|
| 7–8B | khoảng 5–6 GB | Laptop 16 GB RAM |
| 14B | khoảng 10–11 GB | GPU 12 GB trở lên |
| 30–32B | khoảng 22–24 GB | GPU cao cấp |
| 70B | khoảng 45–50 GB | Máy trạm, nhiều GPU |
Sinh viên nên bắt đầu ở mức 7–8B: đủ dùng cho đồ án và máy không bị treo.
LLM tiếng Việt: hiện trạng và cách chọn
Việt Nam có bộ đánh giá riêng tên VMLU, do JAIST và Zalo AI phát triển, gồm 10.880 câu hỏi thuộc 58 chủ đề. Các mô hình nội địa từng được nhắc gồm KiLM (Zalo AI), ViGPT (VinBigData), PhoGPT (VinAI) và Vistral.
Tuy nhiên, số liệu xếp hạng công khai mà tôi kiểm chứng được là từ 2024–2025, nên đã cũ. Lời khuyên thực dụng: hãy tự dựng 20–30 câu hỏi đúng bài toán của bạn rồi chấm điểm.
API trả phí hay mô hình mở?
| Tiêu chí | API trả phí | Mô hình mở chạy máy |
|---|---|---|
| Chất lượng | Cao nhất hiện nay | Khá, kém hơn ở bài khó |
| Chi phí | Trả theo token | Miễn phí, tốn phần cứng |
| Dữ liệu | Gửi lên máy chủ hãng | Không rời khỏi máy bạn |
| Hợp với | Sản phẩm thật, demo | Đồ án, dữ liệu nhạy cảm |
Hạn chế của LLM và cách đối phó
Hiểu LLM là gì cũng có nghĩa là biết nó làm sai ở đâu. Ba hạn chế sau bạn sẽ gặp ngay tuần đầu.
Hallucination — mô hình bịa thông tin
Hallucination là hiện tượng mô hình đưa ra thông tin sai nhưng nghe rất thuyết phục. Ví dụ: bạn hỏi cách dùng một thư viện, mô hình trả về tên hàm không hề tồn tại.
Nguyên nhân nằm ở bản chất: mô hình tối ưu để tạo chuỗi token hợp lý, không phải đúng sự thật. Cách hạn chế: yêu cầu nêu nguồn rồi tự kiểm tra, chạy thử mọi đoạn code, và cấp tài liệu thật qua RAG.
Knowledge cutoff và bảo mật
Mỗi mô hình có một mốc dữ liệu huấn luyện, gọi là knowledge cutoff. Sau mốc đó nó không biết gì thêm, nên hay nhắc tới phiên bản thư viện đã cũ.
Về bảo mật, nhiều công ty cấm dán code nội bộ lên chatbot miễn phí. Sinh viên thực tập nên hỏi mentor về chính sách AI trước khi dùng.
LLM liên quan gì tới RAG, AI agent và AI coding?
LLM là nền. Các khái niệm sau xây trên nền đó:
- Prompt engineering: viết câu lệnh để nhận kết quả ổn định.
- RAG: tìm tài liệu liên quan rồi nhét vào prompt.
- AI agent: LLM được cấp công cụ, tự lên kế hoạch nhiều bước. Xem bài AI Agent là gì.
- AI coding: dùng LLM khi lập trình hằng ngày, qua công cụ như Claude Code, Cursor hay Copilot.
Sinh viên IT nên học gì về LLM? Lộ trình 3 bước
- Bước 1 — Dùng thành thạo (2–4 tuần). Gọi API, chỉnh tham số, viết prompt tốt. Cần Python cơ bản, không cần toán.
- Bước 2 — Xây ứng dụng (1–3 tháng). Làm chatbot trả lời trên tài liệu riêng, cần thêm embedding và vector database.
- Bước 3 — Đi sâu (6 tháng trở lên). Fine-tuning và kiến trúc mô hình. Chỉ đi bước này nếu nhắm vị trí AI engineer.
Câu hỏi thường gặp về LLM
LLM là gì, nói thật ngắn gọn?
LLM là mô hình ngôn ngữ lớn: một mạng nơ-ron học từ lượng văn bản khổng lồ để dự đoán token tiếp theo. Nhờ dự đoán liên tiếp, nó sinh ra câu trả lời, đoạn văn và code. Mọi công cụ AI coding bạn đang dùng đều chạy trên một LLM nào đó.
LLM và ChatGPT có phải là một không?
Không. LLM là mô hình — phần lõi dự đoán token. ChatGPT là sản phẩm xây trên mô hình đó, kèm giao diện chat, bộ nhớ hội thoại và công cụ bổ sung. Lập trình viên gọi thẳng mô hình qua API, còn người dùng phổ thông dùng sản phẩm.
Sinh viên IT có cần học deep learning để dùng LLM không?
Không cần, nếu mục tiêu là dùng và xây ứng dụng. Bạn chỉ cần Python cơ bản, biết gọi API và viết prompt tốt. Deep learning chỉ thật sự cần khi bạn muốn fine-tuning mô hình hoặc làm nghiên cứu. Hãy bắt đầu từ việc dùng.
LLM nào hỗ trợ tiếng Việt tốt nhất hiện nay?
Chưa có câu trả lời cố định, vì bảng xếp hạng đổi liên tục và số liệu VMLU công khai đã cũ. Các mô hình quốc tế đầu bảng nhìn chung xử lý tiếng Việt khá tốt. Cách đáng tin nhất là tự dựng 20–30 câu hỏi rồi so sánh kết quả.
Chạy LLM trên laptop cần cấu hình gì?
Với mức nén 4-bit, mô hình 7–8B cần khoảng 5–6 GB bộ nhớ, tức laptop 16 GB RAM là chạy được. Mô hình 14B cần khoảng 10–11 GB, còn 70B cần 45 GB trở lên. Sinh viên nên bắt đầu với mô hình 7–8B qua Ollama.
Hallucination là gì và có tránh hoàn toàn được không?
Hallucination là việc mô hình đưa ra thông tin sai nhưng nghe thuyết phục. Không thể loại bỏ hoàn toàn, vì nó xuất phát từ bản chất dự đoán xác suất. Bạn chỉ giảm được rủi ro: cấp tài liệu thật qua RAG, yêu cầu nêu nguồn và chạy thử mọi đoạn code.
Token là gì và vì sao tiếng Việt tốn token hơn tiếng Anh?
Token là mẩu văn bản nhỏ mà mô hình xử lý, có thể là một từ hoặc một phần của từ. Bộ tách token được tối ưu chủ yếu cho tiếng Anh, nên tiếng Việt có dấu thường bị cắt vụn hơn. Cùng một ý, prompt tiếng Việt tốn nhiều token hơn và tốn tiền hơn.
Học về LLM có giúp xin việc dễ hơn không?
Có, nhưng gián tiếp. Rất ít vị trí tuyển người biết LLM thuần túy. Ngược lại, ngày càng nhiều mô tả công việc yêu cầu lập trình viên biết dùng công cụ AI hiệu quả. Kỹ năng gọi API và biết giới hạn của mô hình giúp bạn nổi bật khi phỏng vấn thực tập.
Kết luận: LLM là gì và bước tiếp theo cho bạn
Bạn cần nhớ ít nhất 3 ý sau khi đọc hết bài này, cụ thể như sau. Thứ nhất, LLM là mô hình dự đoán token, không phải cỗ máy biết suy nghĩ. Thứ hai, mọi công cụ AI coding đều chạy trên LLM. Thứ ba, bạn đã gọi được LLM bằng Python.
Bước tiếp theo: chạy đoạn code đếm token, rồi đổi temperature.
CTA cuối bài: Muốn học AI Coding bài bản, làm dự án thật với mentor là lập trình viên đang đi làm? Xem lộ trình khóa học AI Coding tại CodeGym Đà Nẵng hoặc để lại thông tin để được tư vấn.
0 Lời bình