Deep learning (học sâu) là một nhánh của machine learning. Nó dùng mạng nơ-ron nhân tạo nhiều lớp để tự học đặc trưng từ dữ liệu thô: ảnh, âm thanh, văn bản. Chữ “deep” nghĩa là nhiều lớp xếp chồng nhau. Đây là công nghệ đứng sau ChatGPT, Claude, Face ID và xe tự lái.
Deep learning là gì? Định nghĩa dễ hiểu cho sinh viên IT
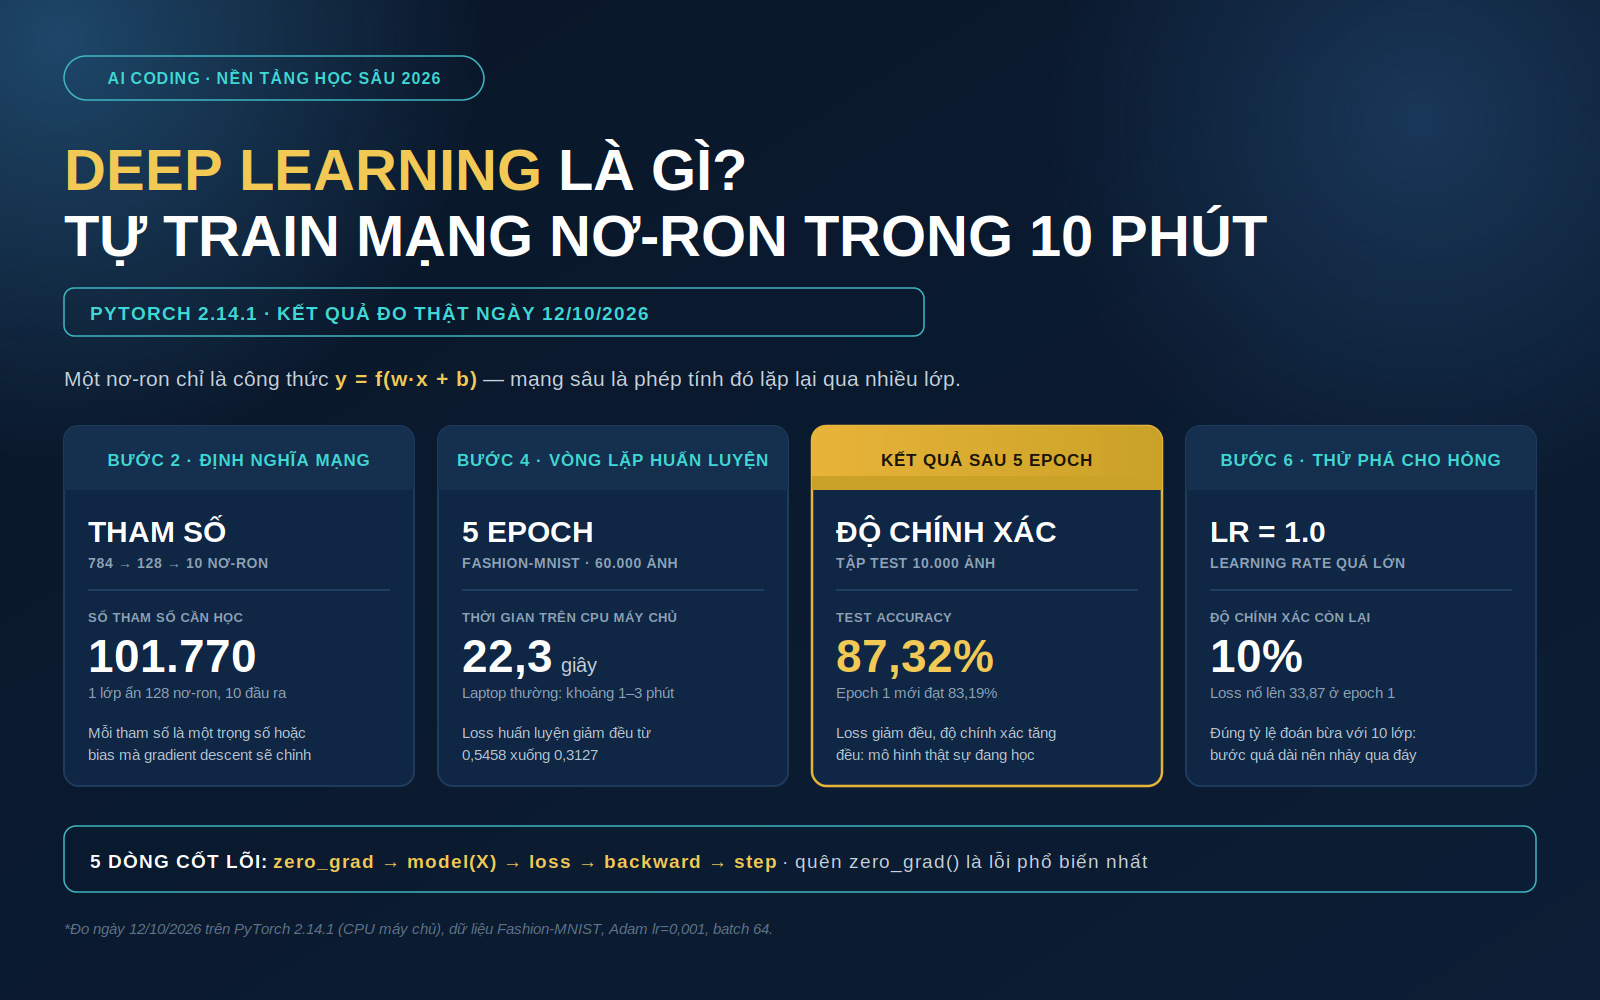
Bài này không dừng ở định nghĩa. Tôi sẽ đi từ một nơ-ron, tính tay một bước học bằng con số, rồi cùng bạn train một mạng nơ-ron trong 10 phút. Code trong bài đã chạy thật trên PyTorch 2.14.1 ngày 12/10/2026.
Deep learning là gì? Định nghĩa dễ hiểu cho sinh viên IT
Deep learning là cách dạy máy học trực tiếp từ dữ liệu thô, qua một mạng nhiều lớp phép tính nối nhau. Mỗi lớp biến đổi dữ liệu một chút. Qua đủ nhiều lớp, mạng tự tìm ra quy luật mà con người không viết nổi thành if-else.
Ba khái niệm lồng nhau như ba vòng tròn, từ ngoài vào trong: AI → machine learning → deep learning. Mọi deep learning đều là machine learning, nhưng ngược lại thì không. Nếu phần nền này còn mới, hãy đọc bài machine learning là gì trước.
So sánh đời thường: dạy trẻ nhận ra con mèo
Cách một: bạn mô tả bằng lời — “tai nhọn, có ria, kêu meo meo”. Đó là machine learning cổ điển: kỹ sư chọn đặc trưng (feature) rồi đưa cho thuật toán.
Cách hai: bạn cho trẻ xem 10.000 tấm ảnh, chỉ nói “mèo” hoặc “không phải mèo”. Trẻ tự rút ra. Đó là deep learning. Nó mạnh nhất ở bài toán con người nhận ra được nhưng mô tả không nổi.
“Deep” là sâu cái gì?
Sâu ở đây là số lớp ẩn (hidden layer) giữa đầu vào và đầu ra. Mô hình nối thẳng vào–ra là “nông”; thêm vài lớp giữa là “sâu”. Mạng nhận diện ảnh thật có hàng chục đến hàng trăm lớp.
Nhiều lớp học được thứ phức tạp vì mỗi lớp xây trên lớp trước. Lớp đầu học cạnh và góc. Lớp giữa ghép thành hình tròn hay kết cấu lông. Lớp cuối ghép thành “mặt mèo”. Thứ bậc này tự hình thành khi huấn luyện, không ai lập trình nó.
Mạng nơ-ron hoạt động như thế nào?
Mạng nơ-ron, bóc hết vỏ thuật ngữ, chỉ là rất nhiều phép nhân và phép cộng. Hiểu một nơ-ron là hiểu 90% phần còn lại của deep learning.
Một nơ-ron chỉ là một công thức
Mạng có ba loại lớp: input, lớp ẩn, output. Mỗi nơ-ron là công thức y = f(w1·x1 + w2·x2 + ... + b)
- x: dữ liệu vào. Ảnh 28×28 điểm ảnh cho 784 giá trị x.
- w: trọng số (weight) — thứ mô hình học.
- b: bias, hằng số cộng thêm để dịch kết quả, cũng được học.
- f: hàm kích hoạt (activation function), bẻ cong kết quả để mạng không chỉ là đường thẳng.
Thử bằng Python thuần:
def relu(z):
    return max(0.0, z)

x = [0.6, 0.9]          # dữ liệu vào
w = [1.5, 2.0]          # trọng số đã học
b = -0.5                # bias

z = x[0]*w[0] + x[1]*w[1] + b   # 0.9 + 1.8 - 0.5
print("z =", z)                  # z = 2.2
print("relu(z) =", relu(z))      # relu(z) = 2.2
Kết quả là 2.2 — toàn bộ “trí tuệ” của một nơ-ron. Mạng 100.000 tham số chỉ là phép tính này lặp lại, có tổ chức.
Mạng nơ-ron có giống não người không?
Không. Nơ-ron nhân tạo chỉ là một hàm toán học cố định, còn nơ-ron thật phóng điện theo thời gian và tự mọc kết nối mới. Deep learning lấy cảm hứng từ não, như máy bay lấy cảm hứng từ chim, nhưng máy bay không vỗ cánh giống chim.
Tham số: con số nói lên độ lớn mô hình
“Tham số” (parameter) là tổng trọng số và bias mà mạng phải học — con số nói lên độ lớn mô hình.
| Mô hình | Số tham số |
|---|---|
| Mạng nhỏ trong bài này | 101.770 |
| ResNet-50 (nhận diện ảnh) | ~25 triệu |
| LLM nguồn mở cỡ nhỏ | 7–8 tỷ |
| LLM thương mại lớn | hàng trăm tỷ |
Hàm kích hoạt: ReLU, sigmoid, softmax
Bỏ hàm kích hoạt thì mạng 50 lớp co lại thành một phép nhân tuyến tính, mất hết khả năng học thứ phức tạp. Ba hàm gặp liên tục:
- ReLU
max(0, z): âm về 0, dương giữ nguyên. Mặc định cho lớp ẩn. - Sigmoid: nén mọi số về 0–1. Với
z = 2.2ở trên, sigmoid cho 0,9002. - Softmax: biến dãy số thành xác suất cộng bằng 1. Dùng ở lớp cuối.
Mô hình “học” bằng cách nào? Gradient descent và backpropagation bằng con số
Mô hình deep learning học bằng cách đoán, đo xem sai bao nhiêu, rồi chỉnh trọng số theo hướng làm cái sai nhỏ lại. Nó sẽ lặp lại hàng triệu lần.
Hàm mất mát và gradient descent: tính tay một bước cập nhật
Hàm mất mát (loss function) biến “đoán sai” thành một con số, đơn giản nhất là loss = (y_dự_đoán − y_thật)². Mục tiêu huấn luyện là tìm bộ trọng số làm loss nhỏ nhất.
Hãy tưởng tượng người bị bịt mắt trên sườn đồi: anh ta sờ xem đất nghiêng về đâu rồi bước một bước nhỏ xuống dốc. “Hướng dốc” là đạo hàm dL/dw, “bước nhỏ” là learning rate:
w_mới = w_cũ − learning_rate × dL/dw
Lấy bài toán nhỏ nhất: một trọng số, y = w·x. Cho x = 2, y_thật = 10, w = 0, learning rate 0,1. Đạo hàm là dL/dw = 2(y_dự_đoán − y_thật)·x.
| Bước | w hiện tại | y dự đoán | loss | dL/dw | w mới |
|---|---|---|---|---|---|
| 1 | 0,0000 | 0,0000 | 100,0000 | −40,0000 | 4,0000 |
| 2 | 4,0000 | 8,0000 | 4,0000 | −8,0000 | 4,8000 |
| 3 | 4,8000 | 9,6000 | 0,1600 | −1,6000 | 4,9600 |
| 4 | 4,9600 | 9,9200 | 0,0064 | −0,3200 | 4,9920 |
Loss từ 100 xuống 0,0064 sau bốn bước; trọng số bò từ 0 lên 4,992, tiến dần tới đáp án đúng là 5. Toàn bộ deep learning là bảng này, chạy cho 101.770 trọng số cùng lúc.
Backpropagation: đưa lỗi ngược về từng lớp
Bảng trên chỉ có một trọng số. Khi mạng nhiều lớp, trọng số ở lớp đầu ảnh hưởng kết quả rất gián tiếp — làm sao biết nó nên tăng hay giảm?
Backpropagation (lan truyền ngược) giải việc đó bằng quy tắc chuỗi (chain rule). Nó tính lỗi ở lớp cuối, rồi truy ngược trách nhiệm về từng lớp trước. Giống huấn luyện viên truy từ bàn thua về hậu vệ. Trong PyTorch, nó gói trong một dòng: loss.backward().
Ba tham số và một cái bẫy
Learning rate là độ dài mỗi bước: quá nhỏ thì học chậm, quá lớn thì loss nổ (mặc định 0,001). Epoch là một lượt đi hết dữ liệu. Batch là số mẫu xử lý cùng lúc trước khi cập nhật trọng số.
Cái bẫy là overfitting: mô hình học thuộc lòng dữ liệu huấn luyện thay vì hiểu quy luật, giống sinh viên học tủ. Dấu hiệu là loss huấn luyện giảm đẹp nhưng độ chính xác trên tập test đứng im. Vì vậy luôn để riêng tập test.
Vì sao deep learning cần GPU? Laptop sinh viên có học được không
Laptop thường đủ để học, không đủ để train model lớn. Bạn cũng không cần mua gì: Colab cho dùng GPU miễn phí.
Bản chất là nhân ma trận song song
Một lớp mạng nơ-ron là một phép nhân ma trận, gồm hàng triệu phép nhân cộng độc lập nhau. CPU có vài chục nhân mạnh và linh hoạt; GPU có hàng nghìn nhân yếu hơn nhưng làm đồng loạt.
Bảng “cần máy gì”
| Việc bạn muốn làm | Cỡ mô hình | Phần cứng đủ dùng |
|---|---|---|
| Học nền tảng, mạng nhỏ (bài này) | dưới 1 triệu tham số | Laptop CPU bất kỳ |
| Train CNN phân loại ảnh | 10–50 triệu | GPU T4 miễn phí trên Colab |
| Fine-tune LLM 7–8 tỷ | 7–8 tỷ | 8–12 GB VRAM (QLoRA) |
| Train LLM từ đầu | hàng trăm tỷ | Cụm hàng nghìn GPU |
Google Colab miễn phí 2026: đọc kỹ trước khi tin
Theo FAQ chính thức của Colab:
- Bản miễn phí chạy tối đa 12 giờ, và còn “tùy khả dụng và cách bạn sử dụng”.
- Google không công bố hạn mức GPU cụ thể vì nó thay đổi theo thời gian.
- Tài nguyên “không được bảo đảm và không phải vô hạn”.
Đừng để việc quan trọng nằm trên một phiên Colab miễn phí.
Muốn học deep learning và AI Coding theo lộ trình có mentor sửa bài? Xem khóa học AI Coding tại CodeGym Đà Nẵng. Học bằng dự án thật, có người review code.
Tự train mạng nơ-ron đầu tiên bằng PyTorch (10 phút, code chạy được)
Bước 0 — Mở Colab và kiểm tra môi trường
Vào colab.research.google.com, tạo notebook mới, bật GPU ở Runtime → Change runtime type → T4 GPU:
import torch
print("Phiên bản PyTorch:", torch.__version__)
print("Có GPU không:", torch.cuda.is_available())
Dòng thứ hai in True là có GPU. Nếu False, bài vẫn chạy trên CPU.
Bước 1 — Tải dữ liệu Fashion-MNIST
Fashion-MNIST gồm 70.000 ảnh xám 28×28 của 10 loại quần áo: 60.000 ảnh để học, 10.000 để kiểm tra.
from torchvision import datasets, transforms
from torch.utils.data import DataLoader

tf = transforms.ToTensor()   # ảnh -> tensor, giá trị 0..1
train_ds = datasets.FashionMNIST(root="data", train=True,  download=True, transform=tf)
test_ds  = datasets.FashionMNIST(root="data", train=False, download=True, transform=tf)

print(len(train_ds), len(test_ds))     # 60000 10000
print(tuple(train_ds[0][0].shape))     # (1, 28, 28)

train_dl = DataLoader(train_ds, batch_size=64, shuffle=True)
test_dl  = DataLoader(test_ds,  batch_size=64)
shuffle=True trộn thứ tự ảnh mỗi epoch, tránh để mô hình học theo trật tự dữ liệu.
Bước 2 — Định nghĩa mạng và đếm tham số
from torch import nn

device = "cuda" if torch.cuda.is_available() else "cpu"

model = nn.Sequential(
    nn.Flatten(),            # 28x28 -> 784 số
    nn.Linear(784, 128),     # lớp ẩn 128 nơ-ron
    nn.ReLU(),               # hàm kích hoạt
    nn.Linear(128, 10),      # 10 đầu ra, ứng 10 loại quần áo
).to(device)

print("Số tham số:", sum(p.numel() for p in model.parameters()))   # 101770
Output là 101.770 — chính những con số mà gradient descent sẽ chỉnh.
Bước 3 — Chọn hàm mất mát và optimizer
loss_fn = nn.CrossEntropyLoss()                       # loss cho phân loại nhiều lớp
opt = torch.optim.Adam(model.parameters(), lr=1e-3)   # lr = 0.001
Bước 4 — Vòng lặp huấn luyện
Đây là trái tim của mọi chương trình deep learning. Năm dòng đánh số ứng đúng lý thuyết ở trên.
for epoch in range(5):
    model.train()
    total = 0.0
    for X, y in train_dl:
        X, y = X.to(device), y.to(device)
        opt.zero_grad()          # 1. xóa gradient bước trước
        pred = model(X)          # 2. forward: mạng đoán
        loss = loss_fn(pred, y)  # 3. đo sai bao nhiêu
        loss.backward()          # 4. backpropagation: tính dL/dw
        opt.step()               # 5. cập nhật trọng số
        total += loss.item() * X.size(0)
    print(f"epoch {epoch+1} | loss {total/len(train_ds):.4f}")
Quên opt.zero_grad() thì gradient các bước cộng dồn và mô hình học sai hoàn toàn — lỗi phổ biến nhất của người mới.
Bước 5 — Kết quả thật sau 5 epoch
Thêm đánh giá trên tập test:
model.eval()
correct = 0
with torch.no_grad():                     # không cần gradient khi chỉ đánh giá
    for X, y in test_dl:
        X, y = X.to(device), y.to(device)
        correct += (model(X).argmax(1) == y).sum().item()
print(f"Độ chính xác tập test: {100*correct/len(test_ds):.2f}%")
Output thật ngày 12/10/2026:
| Epoch | Loss huấn luyện | Độ chính xác tập test |
|---|---|---|
| 1 | 0,5458 | 83,19% |
| 2 | 0,3983 | 85,66% |
| 3 | 0,3608 | 85,79% |
| 4 | 0,3307 | 86,14% |
| 5 | 0,3127 | 87,32% |
Cả 5 epoch mất 22,3 giây trên CPU máy chủ; laptop thường hãy chờ 1–3 phút. Loss giảm đều và độ chính xác tăng đều — dấu hiệu mô hình thật sự học.
Bước 6 — Thử phá cho hỏng để hiểu sâu hơn
Bài tập tôi luôn bắt học viên làm: đổi lr=1e-3 thành lr=1.0 rồi chạy lại.
| Epoch | Loss | Độ chính xác |
|---|---|---|
| 1 | 33,8757 | 10,54% |
| 2 | 2,3761 | 10,00% |
| 3 | 2,3732 | 10,00% |
Loss nổ lên 33,87 rồi mô hình chết hẳn ở 10%. Đó đúng là tỷ lệ đoán bừa với 10 lớp: bước đi quá dài nên nhảy qua đáy. Ngược lại, train 1 epoch chỉ được 83,19% — chưa học đủ, gọi là underfitting.
Ba lỗi thường gặp khi chạy bài này
- Quên
.to(device): lỗi tensor ở hai thiết bị khác nhau. - Hết RAM trên Colab: giảm
batch_sizexuống 32. - Lệch phiên bản: chạy
pip show torch torchvision.
Keras 3 (bản 3.15.1, ngày 29/07/2026) giải cùng bài toán bằng model.fit() ngắn hơn. Nhưng ở đó bạn không thấy loss.backward().
Các kiến trúc deep learning phổ biến: CNN, RNN, Transformer
Cách sắp xếp các lớp quyết định mô hình giỏi việc gì.
CNN (mạng tích chập) dùng bộ lọc nhỏ trượt khắp ảnh để tìm cạnh, góc, kết cấu. Nhờ vậy nó nhận ra con mèo dù mèo ở góc nào. Mốc đáng nhớ là AlexNet năm 2012, thắng cuộc thi ImageNet.
Transformer ra đời năm 2017 từ bài báo Attention Is All You Need. Nó thay bộ nhớ tuần tự bằng cơ chế attention: mỗi từ “nhìn” trực tiếp mọi từ khác và tự quyết định cần chú ý vào đâu. Nhờ đó nó train song song trên GPU rất hiệu quả. Đây là kiến trúc deep learning nền của GPT, Claude, BERT — chi tiết ở bài LLM là gì.
| Kiến trúc | Phù hợp dữ liệu | Ví dụ sản phẩm | Nên học khi nào |
|---|---|---|---|
| MLP (bài này) | bảng số, ảnh nhỏ | phân loại cơ bản | ngay bây giờ |
| CNN | ảnh, video | Face ID, camera giao thông | sau khi xong MLP |
| RNN/LSTM | chuỗi thời gian | dự báo, nhận dạng giọng nói | chỉ khi cần |
| Transformer | văn bản | ChatGPT, Claude, dịch máy | khi muốn làm LLM |
| Diffusion | ảnh, âm thanh | công cụ tạo ảnh AI | khi làm sinh ảnh |
Deep learning khác machine learning truyền thống ở đâu?
Khác biệt lớn nhất không phải “nhiều dữ liệu hơn”, mà là ai chọn đặc trưng.
| Tiêu chí | Machine learning cổ điển | Deep learning |
|---|---|---|
| Đặc trưng | người chọn thủ công | mô hình tự học |
| Dữ liệu cần | hàng nghìn mẫu là đủ | thường hàng chục nghìn trở lên |
| Phần cứng | CPU đủ | thường cần GPU |
| Giải thích kết quả | dễ | khó, gần như hộp đen |
| Phù hợp | dữ liệu bảng, đặc trưng rõ | ảnh, âm thanh, văn bản |
Xem bảng đầy đủ hơn và khi nào nên chọn thuật toán cổ điển ở bài machine learning là gì.
Học deep learning để làm gì năm 2026?
Bạn không cần biết train model từ đầu để làm nghề AI. Nhưng bạn cần hiểu deep learning để không bị mù khi mọi thứ đi sai.
Phần lớn công việc AI trong doanh nghiệp hiện nay là gọi API mô hình có sẵn. Bên cạnh đó là xây hệ thống truy xuất tài liệu (RAG) và fine-tune mô hình nhỏ. Hiểu deep learning giúp bạn làm được ba việc nữa:
- Đọc hiểu tài liệu kỹ thuật của model mới.
- Chọn đúng mô hình theo cỡ và phần cứng.
- Chẩn đoán được khi kết quả tệ.
Chi tiết nghề ở bài AI Engineer là gì.
Về toán, bạn cần ít hơn tưởng tượng: đại số tuyến tính cơ bản, đạo hàm một biến, xác suất. Hiểu bảng gradient descent phía trên là đủ nền. Lộ trình ba bước:
- Python và NumPy cho vững — còn lúng túng với list, dict, vòng lặp thì chưa nên nhảy vào PyTorch.
- PyTorch cộng hai dự án nhỏ: phân loại ảnh và phân loại văn bản.
- Chọn một hướng chuyên sâu: thị giác máy tính, xử lý ngôn ngữ, hoặc LLM và fine-tuning.
Chi tiết từng giai đoạn ở bài lộ trình học AI cho người mới. Về framework, tôi khuyên dứt khoát PyTorch cho người mới: theo tổng hợp của JetBrains năm 2026, PyTorch chiếm khoảng 85% bài báo deep learning tại các hội nghị AI lớn. Đây là số liệu bên thứ ba, nên hãy hiểu là chỉ dấu xu hướng.
Câu hỏi thường gặp về deep learning
Deep learning có phải là AI không?
Có. Deep learning là nhánh của machine learning, và machine learning là nhánh của AI. Thứ tự lồng nhau từ rộng đến hẹp là AI, machine learning, deep learning. Ngược lại thì không đúng: nhiều hệ thống AI không dùng deep learning, ví dụ hệ chuyên gia dựa trên luật viết tay.
Deep learning khác machine learning như thế nào?
Khác biệt cốt lõi là ai chọn đặc trưng. Machine learning cổ điển cần kỹ sư tự xác định đặc điểm nào đáng xem; deep learning tự học từ dữ liệu thô. Đổi lại, deep learning cần nhiều dữ liệu hơn và khó giải thích hơn.
ChatGPT và Claude có phải là deep learning không?
Đúng. Cả hai là mô hình ngôn ngữ lớn dựa trên kiến trúc Transformer, mà Transformer là một mạng nơ-ron sâu. Chúng huấn luyện bằng chính gradient descent và backpropagation mô tả trong bài, chỉ ở quy mô hàng nghìn GPU.
Học deep learning có cần GPU không?
Không cần để bắt đầu. Mạng nhỏ dưới một triệu tham số như ví dụ trong bài chạy xong trong vài phút trên CPU laptop thường. Khi chuyển sang CNN cho ảnh bạn mới cần GPU, và Colab cho dùng miễn phí.
Nên học PyTorch hay TensorFlow?
Với người mới năm 2026, tôi khuyên PyTorch. Cú pháp gần Python thuần nên dễ thấy cơ chế hơn. Phần lớn bài báo deep learning và model nguồn mở cũng dùng PyTorch. Keras 3 tốt nếu bạn muốn viết ngắn gọn.
Mất bao lâu để học deep learning cơ bản?
Nếu đã vững Python, khoảng 2–3 tháng học đều để hiểu mạng nơ-ron và tự train vài mô hình. Thêm 3–6 tháng nữa để đi sâu một hướng như thị giác máy tính hoặc LLM, với điều kiện làm dự án thật.
Kết luận
Deep learning là nhiều lớp phép nhân cộng nối nhau. Sức mạnh của nó đến từ việc mạng tự học đặc trưng. Nó học bằng gradient descent và backpropagation — bạn đã tự chạy điều đó với 101.770 tham số và đạt 87,32% độ chính xác.
Bước tiếp theo: mở lại notebook, đổi mạng thành Linear(784,256) → ReLU → Linear(256,10) và train 10 epoch. Deep learning không phải thứ đọc để biết, mà là thứ chạy để hiểu.
Muốn có người sửa code và chỉ hướng thay vì tự mò? Khóa học AI Coding tại CodeGym Đà Nẵng dạy từ nền tảng AI đến dùng LLM trong dự án thật, có mentor review từng bài. Nhận tư vấn lộ trình miễn phí ngay hôm nay.
0 Lời bình