Vector database là gì? Đây là cơ sở dữ liệu được thiết kế để lưu và tìm kiếm vector embedding — những dãy số biểu diễn ý nghĩa của văn bản, ảnh hoặc âm thanh. Thay vì khớp từ khóa chính xác như SQL, nó trả về dữ liệu gần nhất về ý nghĩa với câu truy vấn của bạn.
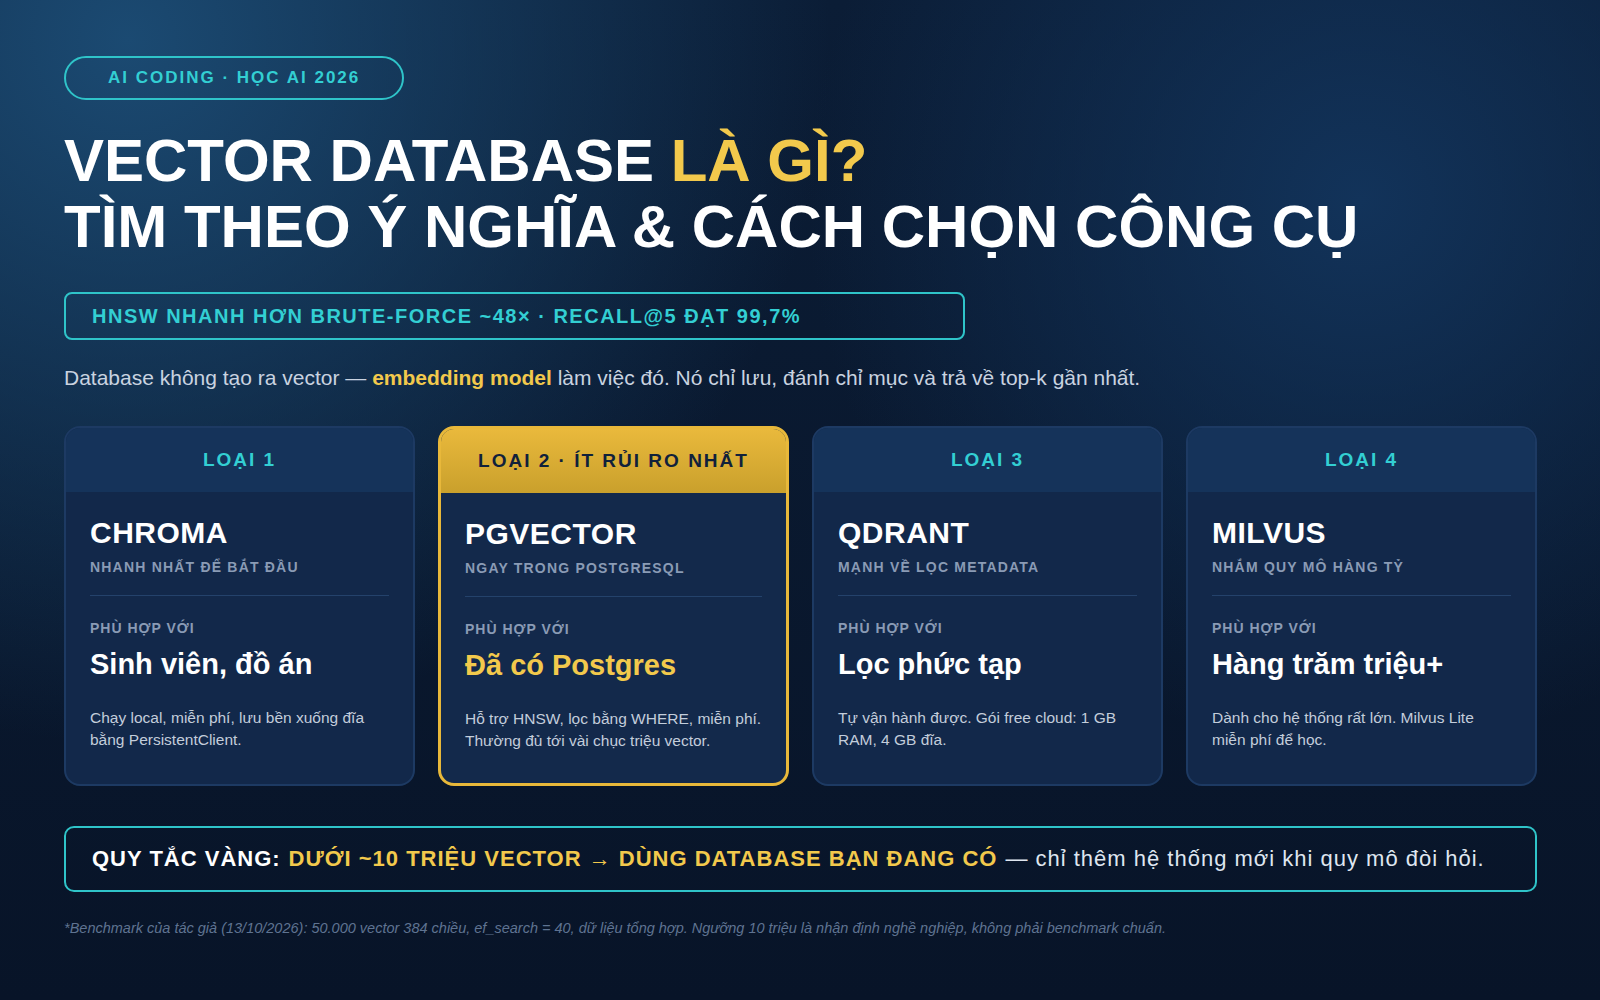
Vector database là gì? Tìm theo ý nghĩa và cách chọn công cụ
Đây là lớp lưu trữ phía sau tìm kiếm ngữ nghĩa, hệ thống gợi ý, chatbot tra cứu tài liệu và bộ nhớ dài hạn của AI agent. Bài viết đi từ con số 0: embedding, chỉ số HNSW, so sánh 6 công cụ 2026 và code Python chạy trên laptop CPU. Benchmark là số đo thật.
Vector database là gì? Giải thích bằng ví dụ đời thường
Vector database là hệ quản trị dữ liệu chuyên lưu vector nhiều chiều và tìm ra k vector gần nhất với một vector truy vấn. Nó không tìm theo từ khóa, mà theo khoảng cách trong không gian.
Ví dụ thư viện: tìm theo tên sách so với tìm theo chủ đề
Bạn vào thư viện và tra mục lục: “cho tôi cuốn Lập trình Python cơ bản“. Thủ thư so khớp đúng từng chữ — đó là cách MySQL làm việc với WHERE title = '...'.
Bây giờ bạn đưa ra một cuốn sách: “tìm mấy cuốn giống cuốn này“. Thủ thư phải hiểu nội dung rồi tìm những cuốn gần nhất về ý nghĩa. Vector database chính là người thủ thư thứ hai.
Ba việc một vector database làm:
Dù là Chroma, Qdrant hay pgvector, mọi công cụ loại này đều làm ba việc:
- Lưu vector kèm metadata — mỗi vector gắn với ID, văn bản gốc và thuộc tính phụ như tác giả, chuyên mục.
- Đánh chỉ mục (index) — để không phải quét toàn bộ kho mỗi lần tìm.
- Trả về top-k gần nhất — bạn đưa vào một vector, nó trả về 3, 5 hay 20 bản ghi giống nhất.
Vector database KHÔNG phải là gì?
Nó không thay thế SQL: dữ liệu người dùng, đơn hàng, giao dịch vẫn nên nằm trong cơ sở dữ liệu quan hệ. Nó cũng không tự “hiểu” dữ liệu của bạn — phần hiểu nằm ở embedding model. Và nó không bắt buộc là sản phẩm riêng: PostgreSQL có pgvector, còn MongoDB, Redis, Elasticsearch đều có vector search sẵn.
Vector embedding là gì? Vì sao dữ liệu phải biến thành dãy số?
Vector embedding là dãy số có độ dài cố định, biểu diễn ý nghĩa của một đoạn dữ liệu. Máy tính không so sánh được “câu này giống câu kia”, nhưng so sánh hai dãy số thì rất nhanh. Embedding là bước phiên dịch giữa hai thế giới đó.
Embedding là tọa độ của ý nghĩa
Hãy hình dung một bản đồ hai chiều, nơi “mèo” nằm sát “chó” và cả hai nằm xa “ô tô”. Khoảng cách phản ánh mức độ liên quan về nghĩa. Thực tế bản đồ ấy có 384 đến 3.072 chiều tùy model, nhưng công thức tính khoảng cách vẫn y nguyên.
Ai tạo ra embedding? Embedding model, không phải database
Đây là điểm sinh viên hay nhầm nhất: vector database không tạo ra vector. Việc đó do embedding model làm.
| Model | Chiều | Chi phí | Ghi chú |
|---|---|---|---|
paraphrase-multilingual-MiniLM-L12-v2 |
384 | Miễn phí, chạy CPU | Nhẹ, đủ cho đồ án |
| BGE-M3 | 1.024 | Miễn phí, nên có GPU | Hỗ trợ tiếng Việt tốt |
OpenAI text-embedding-3-small |
1.536 | Trả tiền theo token | Không tự vận hành |
Hai model đầu tải trực tiếp từ Hugging Face Hub bằng sentence-transformers, không cần API key. Chúng là kết quả của quá trình huấn luyện — xem bài machine learning là gì nếu bạn chưa rõ.
Đo độ giống bằng gì? Cosine, Euclid hay dot product
| Phép đo | Ý nghĩa | Khi nào dùng | Toán tử pgvector |
|---|---|---|---|
| Cosine similarity | Góc giữa hai vector, bỏ qua độ dài | Mặc định cho văn bản, an toàn nhất | <=> |
| Euclidean (L2) | Khoảng cách đường chim bay | Khi độ lớn vector có ý nghĩa | <-> |
| Dot product | Vừa góc vừa độ dài | Nhanh nhất, cần normalize trước | <#> |
Nguồn: tài liệu pgvector trên GitHub, kiểm tra 13/10/2026. Nếu chưa biết chọn gì, hãy dùng cosine — hầu hết embedding model hiện đại được tối ưu cho phép đo này.
Vector database hoạt động như thế nào? Từ brute-force đến chỉ số ANN
Một cơ sở dữ liệu vector nhanh vì nó không so sánh câu truy vấn với toàn bộ dữ liệu. Nó dùng chỉ số ANN (approximate nearest neighbor — láng giềng gần nhất gần đúng) để chỉ xét một phần nhỏ của kho.
Cách ngây thơ: so với từng vector một
Cách đơn giản nhất gọi là brute-force, hay k-NN chính xác: tính khoảng cách tới tất cả vector trong kho rồi lấy k giá trị nhỏ nhất. Kết quả luôn đúng, nhưng chi phí tăng tuyến tính theo số bản ghi.
Với 50.000 vector 384 chiều, một phép nhân ma trận bằng NumPy mất 5,38 ms mỗi truy vấn trên CPU. Nhân lên 1 triệu vector, con số thành khoảng 108 ms. Nếu web có 50 người tìm cùng lúc, CPU sẽ nghẽn ngay.
ANN là gì? Đánh đổi độ chính xác lấy tốc độ
ANN chấp nhận bỏ sót vài kết quả để đổi lấy tốc độ nhanh gấp hàng chục tới hàng trăm lần. Mức “đúng” đo bằng recall: recall@5 bằng 95% nghĩa là trong 5 kết quả trả về, trung bình có 4,75 kết quả thuộc đúng top-5 thật. Mất một kết quả thứ năm hầu như không ai nhận ra, nên đánh đổi này đáng giá.
HNSW là gì? Bản đồ nhiều tầng
HNSW (Hierarchical Navigable Small World) là chỉ số ANN phổ biến nhất hiện nay, do Malkov và Yashunin giới thiệu năm 2016 trong bài báo HNSW trên arXiv.
Hãy hình dung việc đi từ Đà Nẵng tới một con hẻm ở Sài Gòn. Tầng trên cùng chỉ có đường cao tốc: ít điểm, mỗi bước nhảy rất xa. Tầng giữa là đường tỉnh. Tầng dưới cùng là đường làng, chứa toàn bộ các điểm. HNSW xây đồ thị đúng kiểu đó, nên số bước tìm tăng theo hàm logarit thay vì tuyến tính.
Ba tham số quyết định chất lượng chỉ số:
m— số kết nối tối đa của mỗi điểm; lớn thì chính xác hơn nhưng tốn RAM hơn.ef_construction— độ rộng tìm kiếm lúc xây chỉ số; lớn thì chỉ số tốt hơn nhưng build lâu hơn.ef_search— độ rộng tìm kiếm lúc truy vấn; đây là tham số bạn chỉnh được khi hệ thống đã chạy.
Mặc định của pgvector: m = 16, ef_construction = 64, hnsw.ef_search = 40 (README pgvector, 13/10/2026).
Số đo thật: ef_search đổi tốc độ lấy recall thế nào
Tôi dựng 50.000 vector 384 chiều có cấu trúc giống embedding thật. Sau đó, tôi xây chỉ số HNSW bằng hnswlib 0.8.0 (m = 16, ef_construction = 64) rồi chạy 200 truy vấn. Build mất 7,8 giây.
ef_search |
ms / truy vấn | Nhanh hơn brute-force | recall@5 |
|---|---|---|---|
| 10 | 0,073 | 73,7× | 90,6% |
| 20 | 0,127 | 42,5× | 97,6% |
| 40 | 0,112 | 48,2× | 99,7% |
| 80 | 0,178 | 30,3× | 99,9% |
| 200 | 0,470 | 11,4× | 100,0% |
Bảng này nói lên toàn bộ tinh thần của ANN. Tăng ef_search từ 10 lên 40 kéo recall từ 90,6% lên 99,7%, mà truy vấn vẫn nhanh gấp 48 lần. Sau mốc đó, bạn trả thêm nhiều thời gian để mua về rất ít độ chính xác.
Lưu ý trung thực: đây là dữ liệu tổng hợp, không phải embedding từ văn bản thật. Con số tuyệt đối sẽ khác, nhưng hình dạng đường đánh đổi luôn giống như vậy.
IVF, quantization và hybrid search
Ngoài HNSW còn hai kỹ thuật. IVF chia kho thành hàng nghìn cụm và chỉ tìm trong vài cụm gần nhất: build nhanh, ít RAM hơn, nhưng recall thấp hơn. Quantization nén con số trong vector: 32 bit xuống 8 bit giảm RAM khoảng 4 lần.
Hybrid search kết hợp tìm theo ý nghĩa với tìm theo từ khóa (BM25). Tìm ngữ nghĩa giỏi hiểu ý nhưng dở với mã sản phẩm và tên riêng, còn tìm từ khóa thì ngược lại. Bạn cũng thường cần lọc metadata — đây là chỗ các công cụ khác nhau rõ nhất.
Muốn học RAG, cơ sở dữ liệu vector và AI agent trong một lộ trình có mentor review code thật? Xem khóa AI Coding tại CodeGym Đà Nẵng hoặc toàn bộ cụm bài AI Coding.
Hướng dẫn tự xây vector database bằng Python (không cần API key)
Phần này đi từ bước cài đặt. Bạn chỉ cần một laptop CPU, không cần GPU.
Bước 0 — Cài đặt môi trường
# Can Python 3.10 tro len
python3 -m venv venv
source venv/bin/activate        # Windows: venv\Scripts\activate
pip install sentence-transformers chromadb numpy hnswlib
Phiên bản tôi dùng (13/10/2026): sentence-transformers 6.1.0, chromadb 1.5.9, hnswlib 0.8.0. Lần chạy đầu, model tải về khoảng 400 MB nên hơi chậm; những lần sau nằm trong cache.
Bước 1 — Tạo embedding cho câu tiếng Việt
from sentence_transformers import SentenceTransformer
import numpy as np

model = SentenceTransformer("paraphrase-multilingual-MiniLM-L12-v2")

cau = [
    "Thực tập sinh IT cần chuẩn bị CV và portfolio.",
    "Sinh viên năm cuối tìm chỗ thực tập lập trình.",
    "Bún bò Huế ở Đà Nẵng rất ngon.",
    "Chỉ số HNSW giúp tìm vector gần nhất rất nhanh.",
    "Cơ sở dữ liệu vector lưu embedding của tài liệu.",
]

vecs = model.encode(cau, normalize_embeddings=True)
print(vecs.shape)        # (5, 384) -> 5 cau, moi cau 384 chieu
print(np.round(vecs[0][:5], 4))
normalize_embeddings=True đưa mọi vector về độ dài 1. Nhờ vậy dot product và cosine similarity cho cùng kết quả, và phép tính nhanh hơn.
Bước 2 — Tự tính cosine similarity bằng NumPy
Hãy tự tính một lần để thấy bản chất.
def cosine(a, b):
    return float(np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b)))

print(cosine(vecs[0], vecs[1]))   # hai cau ve thuc tap -> diem cao
print(cosine(vecs[0], vecs[2]))   # thuc tap vs bun bo  -> diem thap
Đến đây bạn đã có một “vector database” thu nhỏ. Nó chỉ thiếu chỉ mục, metadata và khả năng lưu xuống đĩa — ba thứ khiến công cụ chuyên dụng tồn tại.
Bước 3 — Lưu và truy vấn bằng Chroma
import chromadb

client = chromadb.PersistentClient(path="./chroma_store")
col = client.create_collection(
    name="bai_viet",
    metadata={"hnsw:space": "cosine"},     # chon phep do khoang cach
)

col.add(
    ids=[f"d{i}" for i in range(len(cau))],
    embeddings=vecs.tolist(),
    documents=cau,
    metadatas=[{"cum": c} for c in
               ["thuc-tap", "thuc-tap", "am-thuc", "ai-coding", "ai-coding"]],
)

qv = model.encode(["làm sao tìm nhanh trong hàng triệu embedding?"],
                  normalize_embeddings=True)[0]
kq = col.query(query_embeddings=[qv.tolist()], n_results=3)
for doc, dist in zip(kq["documents"][0], kq["distances"][0]):
    print(f"{dist:.4f}  {doc}")
PersistentClient ghi dữ liệu xuống ./chroma_store, nên lần sau bạn không phải nhúng lại. Kết quả trả về là cosine distance: càng nhỏ càng giống. Đây là output thật:
cosine distance=0.0113  Co so du lieu vector luu embedding
cosine distance=0.0174  Chi so HNSW tim vector gan nhat rat nhanh
cosine distance=1.0678  Mi quang gan bien My Khe dong khach
Hãy để ý: câu truy vấn không chứa chữ “HNSW”, thế nhưng hai bản ghi đúng chủ đề vẫn lên đầu. Đó là tìm kiếm ngữ nghĩa.
Bước 4 — Lọc metadata và lỗi lệch số chiều
# Chi tim trong cum "thuc-tap"
kq2 = col.query(query_embeddings=[qv.tolist()], n_results=2,
                where={"cum": "thuc-tap"})

# Co tinh dung vector sai so chieu de xem thong bao loi
col.query(query_embeddings=[[0.1] * 16], n_results=1)
Dòng cuối ném ra đúng lỗi sinh viên gặp nhiều nhất:
InvalidArgumentError: Collection expecting embedding with dimension of 384, got 16
Nhớ thông báo này: nó xuất hiện mỗi khi bạn đổi embedding model mà quên tạo lại collection.
Bước 5 — Bản pgvector: PostgreSQL bạn đang có cũng làm được
CREATE EXTENSION IF NOT EXISTS vector;

CREATE TABLE tai_lieu (
  id      bigserial PRIMARY KEY,
  noi_dung text,
  cum      text,
  emb      vector(384)
);

-- Chi so HNSW cho cosine distance
CREATE INDEX ON tai_lieu
  USING hnsw (emb vector_cosine_ops)
  WITH (m = 16, ef_construction = 64);

-- Truy van top-3 gan nhat, co loc metadata
SET hnsw.ef_search = 40;
SELECT id, noi_dung, emb <=> $1 AS khoang_cach
FROM tai_lieu
WHERE cum = 'ai-coding'
ORDER BY emb <=> $1
LIMIT 3;
Chỉ bốn câu lệnh, và bạn đã có vector search ngay trong database đang chạy.
Một giới hạn cần biết: chỉ số pgvector hỗ trợ tối đa 2.000 chiều cho kiểu vector và 4.000 chiều cho halfvec (nguồn: README pgvector, 13/10/2026). Model 1.536 chiều của OpenAI vì vậy cần halfvec.
So sánh vector database phổ biến 2026
Bảng dưới đây gom thông tin tôi kiểm chứng trực tiếp trên trang chủ và repo của từng công cụ ngày 13/10/2026. Giá và hạn mức thay đổi thường xuyên.
| Công cụ | Mã nguồn mở | Gói miễn phí | Phiên bản |
|---|---|---|---|
| pgvector | Có | Miễn phí hoàn toàn | 0.8.7 (01/10/2026) |
| Chroma | Có | Cloud Starter: 5 USD credit | chromadb 1.5.9 |
| Qdrant | Có | 1 GB RAM, 4 GB đĩa, 0,5 vCPU | 1.19.2 (05/10/2026) |
| Milvus / Zilliz | Có | Milvus Lite miễn phí | 3.0.2 (20/09/2026) |
| Pinecone | Không | Starter: 2 GB, 1M read units/tháng | Dịch vụ cloud |
| Weaviate | Có | 100.000 object, 1 GB RAM, 10 GB đĩa | Self-host / Cloud |
Vài điểm đáng chú ý:
- pgvector ít rủi ro nhất: dùng chính Postgres bạn đang có, hỗ trợ HNSW và IVFFlat, miễn phí. Đổi lại, nó không phân tán nên thường dừng ở vài chục triệu vector.
- Chroma nhanh nhất để bắt đầu. Qdrant mạnh về lọc metadata. Milvus nhắm quy mô hàng tỷ vector.
- Gói trả phí của Pinecone bắt đầu từ 20 USD/tháng, tối thiểu 50 USD với bản Standard theo trang giá chính thức; Weaviate có gói Flex từ 45 USD/tháng.
Bạn cũng sẽ gặp Faiss của Meta — một thư viện chỉ số, không phải database — cùng LanceDB và Redis.
Xu hướng 2026: vector search trở thành một kiểu dữ liệu
Hai năm trước, muốn làm tìm kiếm ngữ nghĩa là phải cài thêm một database chuyên dụng. Năm 2026 thì không cần. PostgreSQL có pgvector và pgvectorscale, còn MongoDB Atlas, Redis, Elasticsearch và ClickHouse đều có vector search gốc.
Hệ quả rất thực tế: dưới khoảng 10 triệu vector, database đang dùng thường đã đủ. Con số này là nhận định nghề nghiệp, không phải benchmark chuẩn. Lý do: hybrid search dễ hơn khi dữ liệu nằm cùng một chỗ, và bạn không phải đồng bộ hai nguồn.
Khi nào vẫn cần database chuyên dụng? Khi bạn có hàng trăm triệu vector, độ trễ phải dưới 10 ms, cần multi-tenant tách biệt, hoặc muốn đánh chỉ số trên GPU. Đây cũng là nơi AI agent lưu bộ nhớ dài hạn: mỗi lượt hội thoại được nhúng rồi lưu lại để agent “nhớ” việc tuần trước.
Nên chọn vector database nào?
Khuyến nghị theo tình huống:
- Sinh viên học, làm đồ án: Chroma hoặc pgvector local.
- Đã có PostgreSQL, dưới vài triệu vector: pgvector. Đừng thêm hệ thống mới.
- Cần lọc metadata phức tạp, tự vận hành được: Qdrant.
- Không muốn vận hành gì, có ngân sách: Pinecone hoặc Zilliz Cloud.
- Hàng trăm triệu vector trở lên: Milvus.
RAG (retrieval-augmented generation) ghép hai phần: truy xuất tài liệu liên quan, rồi đưa chúng cho một mô hình ngôn ngữ lớn sinh câu trả lời. Vector database chỉ đảm nhiệm phần truy xuất. Vậy học thứ này ở bước nào? Theo lộ trình học AI cho người mới, thứ tự hợp lý là Python, rồi embedding và vector database, sau đó mới tới RAG và AI agent. Đây cũng là kỹ năng hay được hỏi khi phỏng vấn AI Engineer.
Câu hỏi thường gặp về vector database
Vector database khác gì cơ sở dữ liệu quan hệ như MySQL?
MySQL tìm theo điều kiện chính xác trên cột có chỉ mục B-tree. Cơ sở dữ liệu vector tìm theo độ giống trong không gian nhiều chiều, dùng chỉ số ANN như HNSW. Bạn vẫn có thể lưu vector vào cột thường của MySQL rồi tự tính khoảng cách. Tuy nhiên, mỗi truy vấn phải quét toàn bảng nên cách đó không dùng được ở quy mô lớn.
Có bắt buộc dùng vector database để làm RAG không?
Không bắt buộc. Với vài trăm tài liệu, bạn có thể giữ vector trong một mảng NumPy và tính cosine similarity trực tiếp, đúng như Bước 2 trong bài. Vector database cần thiết khi dữ liệu vượt vài chục nghìn bản ghi, khi cần lưu bền xuống đĩa, hoặc khi cần lọc metadata kèm truy vấn.
Vector database nào miễn phí để sinh viên học?
Chroma, pgvector và Milvus Lite đều miễn phí khi chạy trên máy bạn. Về bản cloud: Qdrant Cloud cho 1 GB RAM và 4 GB đĩa, Weaviate cho gói Free 100.000 object, còn Pinecone Starter cho 2 GB. Số liệu kiểm chứng ngày 13/10/2026.
pgvector có thay được Pinecone không?
Trong phần lớn trường hợp dưới vài chục triệu vector thì có. pgvector hỗ trợ HNSW và lọc metadata bằng WHERE thông thường, lại không tốn chi phí dịch vụ. Pinecone có lợi thế khi bạn không muốn tự vận hành hoặc cần độ trễ thấp ổn định ở quy mô rất lớn.
HNSW là gì và tại sao nhanh hơn tìm kiếm tuyến tính?
HNSW là đồ thị nhiều tầng, hoạt động như cao tốc rồi đường tỉnh rồi đường làng. Nó nhảy xa ở tầng cao để tới gần vùng đích, sau đó tinh chỉnh ở tầng thấp, nên số bước tìm tăng theo hàm logarit. Trong phép đo của tôi với 50.000 vector, HNSW nhanh hơn brute-force khoảng 48 lần ở mức recall 99,7%.
Đổi embedding model thì có phải nhúng lại toàn bộ dữ liệu không?
Phải nhúng lại toàn bộ. Hai model khác nhau tạo ra vector trong hai không gian khác nhau. Vì vậy, điểm khoảng cách giữa chúng vô nghĩa, kể cả khi số chiều tình cờ bằng nhau. Hãy chọn model cẩn thận từ đầu và lưu tên cùng phiên bản model vào metadata của collection.
Vector database có dùng được cho ảnh và âm thanh không?
Có. Nó chỉ quan tâm tới dãy số, không quan tâm dữ liệu gốc là gì. Bạn cần một embedding model phù hợp: CLIP cho ảnh, CLAP hoặc wav2vec cho âm thanh. Sau khi đã có vector, cách lưu và truy vấn hoàn toàn giống với văn bản.
Kết luận
Ba điều cần nhớ. Thứ nhất, cơ sở dữ liệu vector lưu ý nghĩa dưới dạng số và tìm theo độ giống, chứ không khớp từ khóa; phần “hiểu” nằm ở embedding model. Thứ hai, ANN và HNSW là lý do nó nhanh, và ef_search là núm điều chỉnh giữa recall và tốc độ. Thứ ba, năm 2026 hãy bắt đầu bằng Chroma hoặc pgvector, chỉ chuyển sang database chuyên dụng khi quy mô đòi hỏi.
Bước tiếp theo: mở terminal, cài sentence-transformers và chromadb, rồi chạy lại năm bước trên với dữ liệu của bạn.
Muốn học embedding, vector database, RAG và AI agent theo lộ trình có mentor review code thật? Xem khóa AI Coding tại CodeGym Đà Nẵng hoặc cụm bài AI Coding.
0 Lời bình