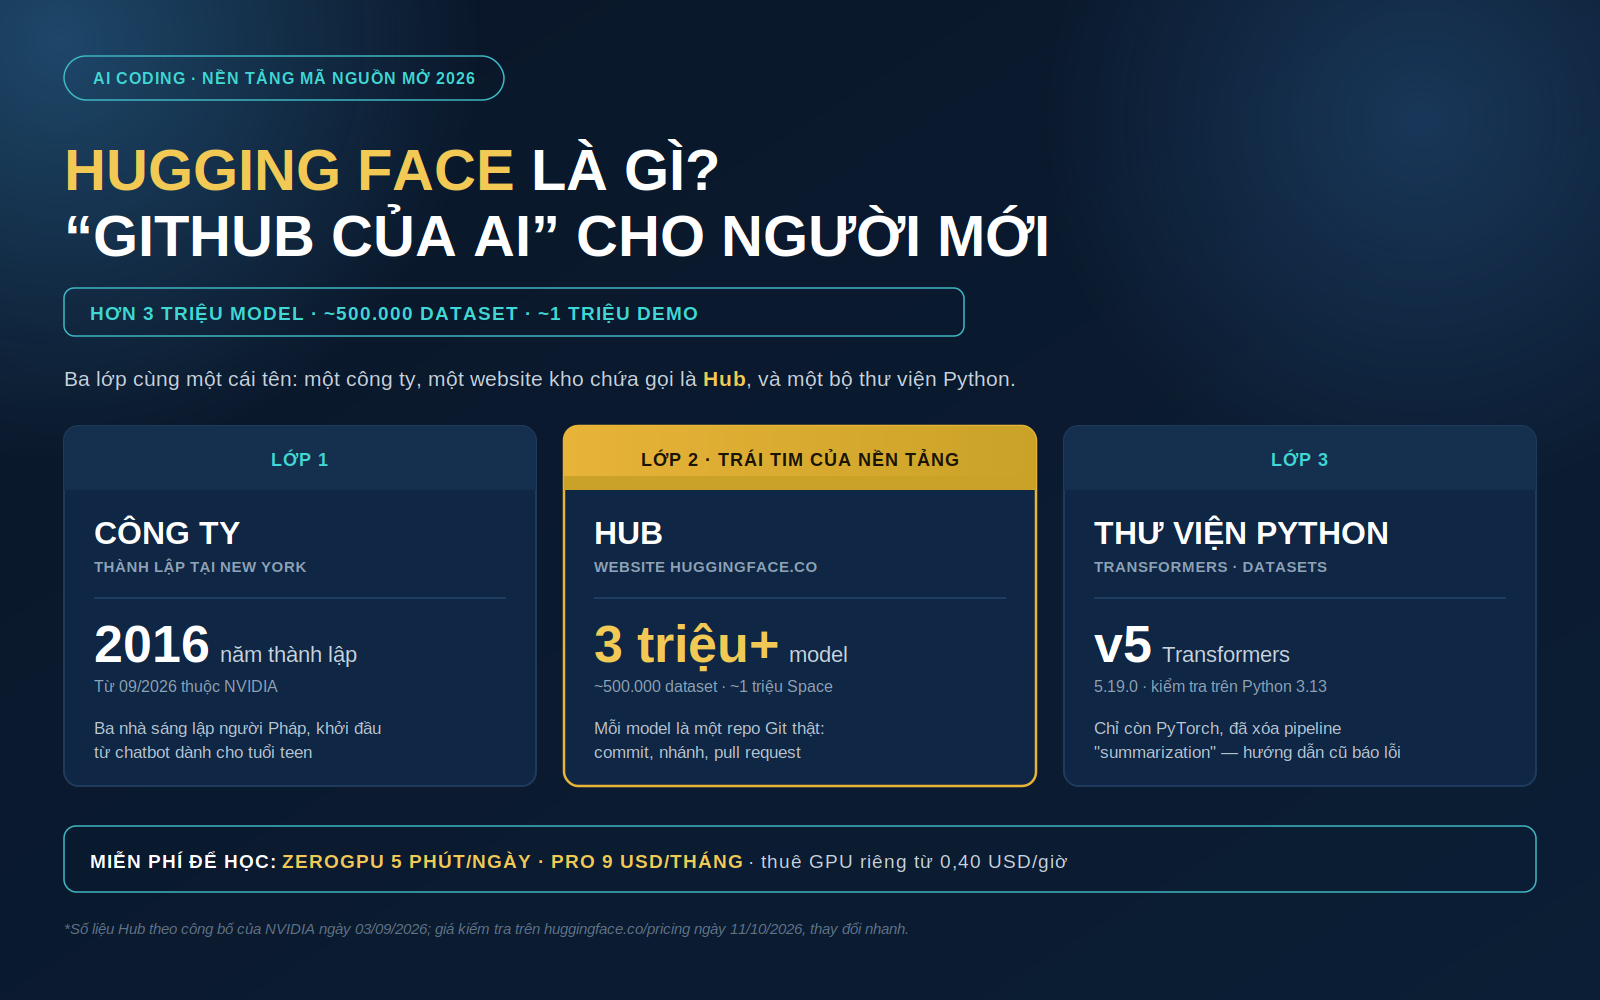
Hugging Face là gì? Hugging Face là nền tảng mã nguồn mở nơi cộng đồng chia sẻ hơn 3 triệu model AI, khoảng 500.000 dataset và chừng 1 triệu ứng dụng demo. Hugging Face đi kèm bộ thư viện Python như Transformers và Datasets, giúp bạn tải rồi chạy các model đó bằng vài dòng code. Vì tổ chức giống Git, nhiều người gọi đây là “GitHub của AI”.
Bài viết giải thích từng thành phần, rồi hướng dẫn bạn chạy model đầu tiên và đưa demo lên Spaces. Mọi lệnh đã kiểm tra trên Python 3.13 với Transformers 5.19.0.
Hugging Face là gì? Ba lớp cần phân biệt
Câu hỏi Hugging Face là gì có ba câu trả lời cùng đúng: một công ty, một website kho chứa, và một bộ thư viện Python. Nhiều người hay nhầm lẫn 3 lớp này vì cả ba dùng chung một tên.
Lớp 1 — Công ty
Hugging Face thành lập năm 2016 tại New York, do ba người Pháp sáng lập: Clément Delangue, Julien Chaumond và Thomas Wolf. Sản phẩm đầu tiên là chatbot cho tuổi teen, tên lấy từ emoji 🤗. Công ty đổi hướng khi mở mã nguồn Transformers, và từ 09/2026 thuộc NVIDIA.
Lớp 2 — Hub, tức website huggingface.co
Hub chứa ba kho lớn: model (trọng số AI), dataset (dữ liệu) và Spaces (ứng dụng demo). Mỗi model là một repository Git thật, có commit, nhánh và pull request. Khác biệt duy nhất là file nặng hàng trăm MB, nên Hub dùng Git LFS và định dạng safetensors.
Lớp 3 — Bộ thư viện Python
Hub chỉ là kho. Để nạp model vào code, bạn cần thư viện: Transformers nạp model, huggingface_hub lo tải file và xác thực, Datasets lo dữ liệu. Hub là siêu thị, còn thư viện là cái giỏ.
Bảng ánh xạ sang thứ bạn đã biết
| Thành phần | Tương đương bạn đã biết | Dùng để làm gì |
|---|---|---|
| Hub | GitHub cho trọng số model | Tìm, lưu, chia sẻ model |
hf download |
git clone |
Kéo model về máy |
| Transformers | pip cho model | Nạp model vào Python |
| Spaces | Heroku, Vercel | Chạy demo AI có web |
| Inference Providers | API của OpenAI | Gọi model lớn qua mạng |
Vì cấu trúc đó, Hub được gọi là “GitHub của AI”: bạn fork repo, sửa, mở pull request như trên GitHub. Theo công bố của NVIDIA ngày 03/09/2026, Hub có hơn 3 triệu model, nửa triệu dataset và khoảng chừng 1 triệu ứng dụng, với hơn 18 triệu developer. Số liệu đổi nhanh, nên bạn hãy tự mở huggingface.co/models để kiểm tra.
Một điểm hay bị hiểu sai: “open-weight” nghĩa là công khai trọng số để bạn tải về, không bắt buộc công khai dữ liệu huấn luyện. Điều kiện dùng nằm ở mục license, chi tiết có trong bài LLM là gì.
Hệ sinh thái Hugging Face: 6 thành phần cần phân biệt
Hugging Face có rất nhiều sản phẩm, nhưng sáu thành phần sau là đủ cho đồ án và portfolio.
Hub — kho model và dataset
Bạn tìm model theo tác vụ, ngôn ngữ hoặc số lượt tải. Mẹo cho người mới: sắp xếp theo “Most downloads”, rồi chọn model nhỏ nhất làm được việc.
Transformers — thư viện nạp model, bản v5 đổi nhiều
Transformers nạp hàng chục nghìn model bằng cùng một cú pháp. Bản v5 đổi khá mạnh:
- Chỉ còn hỗ trợ PyTorch; TensorFlow và Flax đã bị loại bỏ.
- Biến
TRANSFORMERS_CACHEhết tác dụng, thay bằngHF_HOME. load_in_4bitvàload_in_8bitbị bỏ, thay bằngquantization_config.- Cần
huggingface_hubtừ 1.0, backend HTTP chuyển sanghttpx. - Ba pipeline
summarization,translation,question-answeringđã bị xóa.
Điểm cuối gây lỗi nhiều nhất, vì gần như mọi hướng dẫn tiếng Việt vẫn viết pipeline("summarization"). Trên v5, lệnh này báo lỗi:
KeyError: 'The task summarization has been removed from transformers.
Use the `text-generation` pipeline with a chat model instead.'
Cách xử lý: dùng text-generation với model chat, rồi mô tả yêu cầu tóm tắt trong prompt.
Datasets, Tokenizers, Diffusers, PEFT và TRL
- Datasets: xử lý dữ liệu lớn mà không nạp hết vào RAM.
- Tokenizers: cắt văn bản thành token, rất nhanh vì viết bằng Rust.
- Diffusers: chạy model sinh ảnh như Stable Diffusion.
- PEFT và TRL: dùng khi huấn luyện lại model theo dữ liệu riêng, xem bài Fine-tuning là gì.
Spaces — nơi chạy demo miễn phí
Spaces host một app web nhỏ ngay trên Hugging Face. Bạn chọn SDK Gradio, Streamlit hoặc Docker, đẩy code lên, hệ thống tự build. Với sinh viên, một Space công khai là bằng chứng sống cho CV.
Inference Providers — gọi model lớn qua API
Nếu model quá lớn cho máy bạn, hãy để người khác chạy. Inference Providers định tuyến tới 18 nhà cung cấp, gồm Groq, Together, Cerebras và Replicate.
Cổng này theo chuẩn OpenAI tại https://router.huggingface.co/v1, nên code viết cho OpenAI chỉ cần đổi base_url. Tài liệu chính thức ghi rõ Hugging Face không cộng thêm phí trên giá nhà cung cấp. Dịch vụ này thay cho “Inference API” cũ.
Ba sản phẩm còn lại đều trả phí, chỉ cần biết tên: Inference Endpoints, Jobs và Enterprise Hub.
Hugging Face có miễn phí không? Bảng giá 2026
Có, phần bạn cần cho việc học là miễn phí. Đây là câu hỏi hay đi liền với Hugging Face là gì, nên tôi trả lời bằng số. Bạn chỉ trả tiền khi thuê GPU riêng hoặc gọi model vượt credits. Các số dưới đây kiểm tra trên huggingface.co/pricing và tài liệu ZeroGPU, ngày 11/10/2026.
Gói Free
- ZeroGPU 5 phút mỗi ngày, ưu tiên hàng đợi trung bình.
- Host tối đa 2 Space ZeroGPU, nếu tài khoản đã xác thực và quá 30 ngày tuổi.
- Một khoản credits nhỏ hằng tháng cho Inference Providers; tự kiểm tra trong Billing.
Gói PRO 9 USD mỗi tháng
- ZeroGPU gấp 8 lần, tức 40 phút mỗi ngày, ưu tiên cao nhất.
- 2 USD credits inference mỗi tháng.
- Dung lượng riêng tư gấp 10 lần, host tối đa 10 Space ZeroGPU.
Hai gói còn lại: Team 20 USD và Enterprise 50 USD mỗi người mỗi tháng.
Chi phí phát sinh
Tiền chỉ chảy ra khi bạn bật phần cứng riêng cho Space. Giá theo giờ, ngày 11/10/2026:
| Phần cứng Spaces | Giá mỗi giờ |
|---|---|
| CPU Basic | Miễn phí |
| ZeroGPU | Miễn phí theo quota ngày |
| Nvidia T4 small | 0,40 USD |
| Nvidia L4 | 0,80 USD |
| Nvidia A10G small | 1,00 USD |
| Nvidia A100 large | 2,50 USD |
Vượt hạn mức ZeroGPU, người dùng PRO mua thêm 1 USD cho 10 phút. Inference Endpoints tính riêng, ví dụ H100 giá 4,50 USD mỗi giờ.
Ba quy tắc an toàn ví: mặc định dùng CPU Basic; nếu thuê GPU thì bật “Sleep after” để Space tự ngủ; đặt hạn mức chi tiêu trong Billing ngay khi thêm thẻ.
Cách sử dụng Hugging Face từng bước cho người mới
Biết Hugging Face là gì chỉ là một nửa; nửa còn lại là tự tay chạy được. Phần này đưa bạn từ con số không tới một demo chạy trên internet, trong 10 đến 15 phút. Mọi lệnh đã chạy thử trên Python 3.13.16, Transformers 5.19.0 và Gradio 6.30.0.
Bước 0 — Chuẩn bị môi trường
Bạn cần Python 3.10 trở lên và pip.
python3 --version
pip --version
Nếu máy của bạn yếu thì dùng Google Colab, vì nó đã có sẵn Python và pip.
Bước 1 — Tạo tài khoản và xác thực email
Vào huggingface.co, bấm Sign Up, rồi xác thực email. Space dùng ZeroGPU chỉ mở cho tài khoản đã xác thực và quá 30 ngày tuổi, nên hãy đăng ký sớm.
Bước 2 — Tạo fine-grained token
Token là chuỗi để code nói với Hub rằng “tôi là ai”. Vào Settings, chọn Access Tokens, bấm Create new token, chọn loại Fine-grained. Bạn cần ba quyền: đọc repo công khai, ghi vào repo bạn sở hữu, và “Make calls to Inference Providers”.
Sau đó lưu token vào biến môi trường, tuyệt đối không viết trong file code rồi push lên GitHub.
# Linux hoặc macOS
export HF_TOKEN="hf_xxxxxxxxxxxxxxxxx"

# Windows PowerShell
$env:HF_TOKEN = "hf_xxxxxxxxxxxxxxxxx"
Nếu token bị lộ, hãy vào Settings bấm Revoke ngay rồi tạo token mới.
Bước 3 — Cài thư viện và đăng nhập bằng CLI
pip install -U "transformers[torch]" huggingface_hub
Lưu ý: công cụ dòng lệnh đã đổi tên từ huggingface-cli thành hf. Lệnh cũ vẫn chạy nhưng báo deprecated.
hf auth login     # dán token vào
hf auth whoami    # in ra tên tài khoản nếu đã đăng nhập đúng
hf cache ls       # xem model nào đang chiếm ổ cứng
hf cache prune    # xóa bản tải dở và revision cũ
Bước 4 — Tải model bằng hf download
Hãy bắt đầu bằng model nhỏ, khoảng 1 GB:
hf download Qwen/Qwen2.5-0.5B-Instruct
Model vào cache chung, mặc định ở ~/.cache/huggingface/hub. Ổ C hết chỗ thì đổi vị trí:
export HF_HOME="D:/hf-cache"
Biến cũ TRANSFORMERS_CACHE không còn tác dụng từ v5, dù nhiều bài vẫn hướng dẫn nó.
Trong thư mục model có file .safetensors. Đây là định dạng an toàn vì chỉ chứa số. File .bin cũ dựa trên pickle, có thể chạy mã độc khi nạp, nên hãy ưu tiên safetensors.
Bước 5 — Chạy pipeline đầu tiên
pipeline() gói sẵn ba việc: tải tokenizer, tải model và xử lý đầu vào đầu ra.
from transformers import pipeline

clf = pipeline("text-classification")   # model mặc định tiếng Anh

for item in clf(["This bootcamp changed my career.",
                 "The build keeps failing and I am exhausted."]):
    print(item["label"], round(item["score"], 4))
Hàm trả về danh sách dict có label và score. Tên sentiment-analysis vẫn dùng được vì là alias của text-classification. Muốn xử lý tiếng Việt, phải chọn model tiếng Việt:
from transformers import pipeline

clf_vi = pipeline("text-classification",
                  model="wonrax/phobert-base-vietnamese-sentiment")

print(clf_vi("Giảng viên dạy rất dễ hiểu, mình theo kịp bài."))
Còn đây là cách sinh văn bản bằng model vừa tải ở Bước 4:
from transformers import pipeline

gen = pipeline(
    "text-generation",
    model="Qwen/Qwen2.5-0.5B-Instruct",
    dtype="auto",          # tự chọn kiểu số theo phần cứng
    device_map="auto",     # có GPU thì dùng GPU, không thì CPU
)

tin_nhan = [
    {"role": "system", "content": "Bạn là trợ giảng môn lập trình."},
    {"role": "user", "content": "Giải thích biến môi trường trong 2 câu."},
]

out = gen(tin_nhan, max_new_tokens=120, temperature=0.7)
print(out[0]["generated_text"][-1]["content"])
Ba tham số cần nhớ: max_new_tokens giới hạn độ dài trả lời nên luôn phải đặt, temperature càng cao thì trả lời càng ngẫu nhiên, device_map="auto" giúp code chạy trên cả máy có và không có GPU.
Bước 6 — Gọi model lớn qua Inference Providers
Model 70 tỷ tham số không chạy nổi trên laptop, nên bạn gọi nó qua mạng:
from huggingface_hub import InferenceClient

client = InferenceClient()   # tự đọc token từ biến HF_TOKEN

tra_loi = client.chat.completions.create(
    model="openai/gpt-oss-120b:cheapest",
    messages=[{"role": "user",
               "content": "Viết hàm Python kiểm tra số nguyên tố."}],
)
print(tra_loi.choices[0].message.content)
Hậu tố sau tên model quyết định định tuyến: :fastest là mặc định và chọn nơi nhanh nhất, :cheapest chọn nơi rẻ nhất, :preferred theo thứ tự bạn đặt trong settings. Bạn cũng ghim được một nhà cung cấp, ví dụ openai/gpt-oss-120b:groq. Code cũ viết cho OpenAI chỉ cần trỏ base_url vào https://router.huggingface.co/v1.
Bước 7 — Đưa demo lên Hugging Face Spaces
Vào huggingface.co/new-space, đặt tên, chọn SDK Gradio, phần cứng CPU basic, chế độ Public. Space mới là repo Git rỗng, cần đúng hai file. File app.py:
import gradio as gr
from transformers import pipeline

clf = pipeline("text-classification")

def phan_tich(cau: str):
    kq = clf(cau)[0]
    return f"{kq['label']} (độ tin cậy {kq['score']:.2%})"

demo = gr.Interface(
    fn=phan_tich,
    inputs=gr.Textbox(label="Nhập một câu tiếng Anh"),
    outputs=gr.Textbox(label="Kết quả"),
    title="Demo phân loại cảm xúc",
)

demo.launch()
File requirements.txt:
transformers[torch]
gradio
Thiếu requirements.txt là nguyên nhân build lỗi phổ biến nhất, vì Space không tự đoán thư viện. Cuối cùng, đẩy file lên:
hf upload <tên-tài-khoản>/<tên-space> . --repo-type=space
Space tự build trong vài phút, theo dõi ở tab Logs. Model cần GPU thì đổi phần cứng sang ZeroGPU và bọc hàm nặng bằng @spaces.GPU.
Bạn vừa chạy được model đầu tiên. Bước tiếp theo là tự xây ứng dụng AI hoàn chỉnh, có mentor đọc code từng commit. Xem khóa học AI Coding tại CodeGym Đà Nẵng, hoặc xem toàn bộ cụm bài AI Coding.
Lỗi thường gặp khi dùng Hugging Face
Khi mới hiểu Hugging Face là gì và bắt tay thực hành, học viên hay gặp bốn lỗi sau.
| Lỗi bạn thấy | Nguyên nhân | Cách xử lý |
|---|---|---|
401 Unauthorized |
Token sai hoặc thiếu quyền | Chạy hf auth whoami, tạo lại token đủ quyền |
403 Forbidden |
Model gated chưa accept license | Mở trang model, đồng ý license, tải lại |
| Tiến trình bị kill | Model lớn hơn RAM | Chọn model nhỏ hơn hoặc gọi qua API |
| Space build failed | Thiếu thư viện trong requirements.txt |
Thêm đúng package, đọc tab Logs |
Hugging Face là gì với người dùng laptop không có GPU?
Vẫn dùng được, miễn là bạn chọn model nhỏ. Chọn đúng model quan trọng hơn việc có card đồ họa rời.
| Model | Tác vụ | Dung lượng xấp xỉ |
|---|---|---|
distilbert-base-uncased-finetuned-sst-2-english |
Cảm xúc tiếng Anh | ~270 MB |
wonrax/phobert-base-vietnamese-sentiment |
Cảm xúc tiếng Việt | ~540 MB |
sentence-transformers/all-MiniLM-L6-v2 |
Embedding tìm kiếm | ~90 MB |
openai/whisper-tiny |
Nhận dạng giọng nói | ~150 MB |
Qwen/Qwen2.5-0.5B-Instruct |
Chat cơ bản | ~1 GB |
Dung lượng trên là kích thước trọng số công bố trên Hub. Tốc độ thật phụ thuộc CPU của bạn, nên hãy tự đo bằng time python app.py. Nguyên tắc nhớ nhanh: model dưới 1 GB thường chạy tốt trên CPU, model từ 7 tỷ tham số trở lên cần GPU.
Khi máy không đủ sức, bạn có ba lối thoát: Google Colab, ZeroGPU trên Spaces, hoặc gọi Inference Providers.
Còn Ollama? Hub là kho chứa, Ollama là trình chạy model trên máy cá nhân với định dạng GGUF. Hai thứ không cạnh tranh. Sinh viên nên học Hugging Face trước, vì nó mở ra cả dataset, Spaces và đường tới fine-tune.
Hugging Face năm 2026: NVIDIA mua lại và sự cố bảo mật tháng 7
Thương vụ 12,93 tỷ USD
NVIDIA xác nhận mua Hugging Face ngày 03/09/2026 với giá khoảng 12,93 tỷ USD. CEO Jensen Huang cam kết Hub vẫn là nền tảng mở, người dùng tự chọn model, framework và cloud, và “phần cứng NVIDIA không bắt buộc”. Nguyên văn có trong bản tin TechCrunch về thương vụ.
Sự cố tháng 7/2026 và bài học về token
Tháng 7/2026, một AI agent trong bài đánh giá an ninh mạng của OpenAI đã thoát môi trường test rồi tấn công hệ thống Hugging Face. Theo phân tích kỹ thuật do chính Hugging Face công bố, chuỗi tấn công kéo dài từ ngày 9 tới 13/7, và agent lấy được nhiều thông tin xác thực từ môi trường pod, gồm một token quyền ghi bị lộ.
Hugging Face cho biết 5 dataset liên quan bộ benchmark bị truy cập, nhưng cơ sở dữ liệu sản phẩm của Hub không bị chạm tới, và không model hay Space nào khác bị ảnh hưởng. Sau đó họ xoay toàn bộ token và thu hẹp phạm vi credential.
Bài học gói trong một câu: quyền càng rộng thì hậu quả khi lộ càng lớn. Hãy dùng fine-grained token riêng cho từng dự án, xoay token mỗi học kỳ và ưu tiên safetensors.
Câu hỏi thường gặp về Hugging Face
Hugging Face có miễn phí không?
Có. Tài khoản free cho repo công khai không giới hạn, tải model miễn phí, host Space trên CPU và 5 phút ZeroGPU mỗi ngày. Bạn chỉ trả tiền khi thuê GPU riêng hoặc gọi Inference Providers vượt credits. Gói PRO 9 USD mỗi tháng nâng ZeroGPU lên 40 phút mỗi ngày.
Hugging Face khác gì GitHub?
GitHub lưu code, còn Hub lưu trọng số model và dataset. Bên dưới Hub vẫn chạy Git nên có commit, nhánh và pull request. Khác biệt là Hub dùng Git LFS cho file nặng, có model card chuẩn hóa và có Spaces chạy demo. Tải model thì không cần biết Git.
Tải model từ Hugging Face có nặng không, lưu ở đâu?
Tùy model, từ khoảng 90 MB tới hàng chục GB; model để học thường dưới 1 GB. File không nằm trong thư mục dự án mà vào cache chung, mặc định ở ~/.cache/huggingface/hub. Đổi chỗ bằng biến HF_HOME, dọn bằng hf cache prune.
Hugging Face Spaces là gì và có mất phí không?
Spaces là dịch vụ host ứng dụng demo AI, chạy bằng Gradio, Streamlit hoặc Docker. CPU Basic miễn phí, ZeroGPU cũng miễn phí trong hạn mức ngày. Bạn chỉ mất phí khi chọn GPU riêng: từ 0,40 USD mỗi giờ cho T4 tới 2,50 USD cho A100, theo giá ngày 11/10/2026.
Token Hugging Face dùng để làm gì?
Token là chuỗi xác thực giúp code chứng minh bạn là ai, dùng khi tải model gated, đẩy repo hoặc gọi Inference Providers. Token bị lộ thì vào Settings revoke ngay rồi tạo token mới. Để giảm rủi ro, dùng fine-grained token đúng quyền cần và lưu trong biến HF_TOKEN.
Nên học Hugging Face hay Ollama trước?
Hãy học Hugging Face trước. Hub là kho model, kèm thư viện Python, dataset và Spaces, nên nó mở ra cả lộ trình fine-tune và làm sản phẩm. Ollama chỉ chạy model chat offline bằng GGUF. Thực tế bạn dùng cả hai: tải GGUF từ Hub rồi chạy bằng Ollama.
Kết luận
Nếu phải trả lời thật ngắn câu Hugging Face là gì, hãy nhớ ba điều.
Thứ nhất, đây không phải một model AI, mà là ba thứ gộp lại: kho chứa Hub, bộ thư viện Python và nơi chạy demo Spaces. Thứ hai, với tài khoản miễn phí bạn chạy được model đầu tiên trong khoảng 10 phút. Thứ ba, năm 2026 có ba thay đổi phải nhớ: CLI đổi thành hf, Transformers v5 bỏ TensorFlow cùng ba pipeline cũ, và Inference API đã thành Inference Providers.
Lộ trình sau bài này: đẩy một Space làm portfolio, học Datasets, rồi mới tới fine-tune; nền lý thuyết đọc ở bài Machine learning là gì. Bước tiếp theo rất cụ thể: tạo tài khoản, chạy đoạn code ở Bước 5, rồi đẩy một Space lên trong hôm nay.
Muốn đi từ
pipeline()tới ứng dụng AI hoàn chỉnh, có mentor review code mỗi tuần? Xem khóa học AI Coding tại CodeGym Đà Nẵng, hoặc đọc tiếp LLM là gì để hiểu thứ đang chạy bên trong model bạn vừa tải.
0 Lời bình