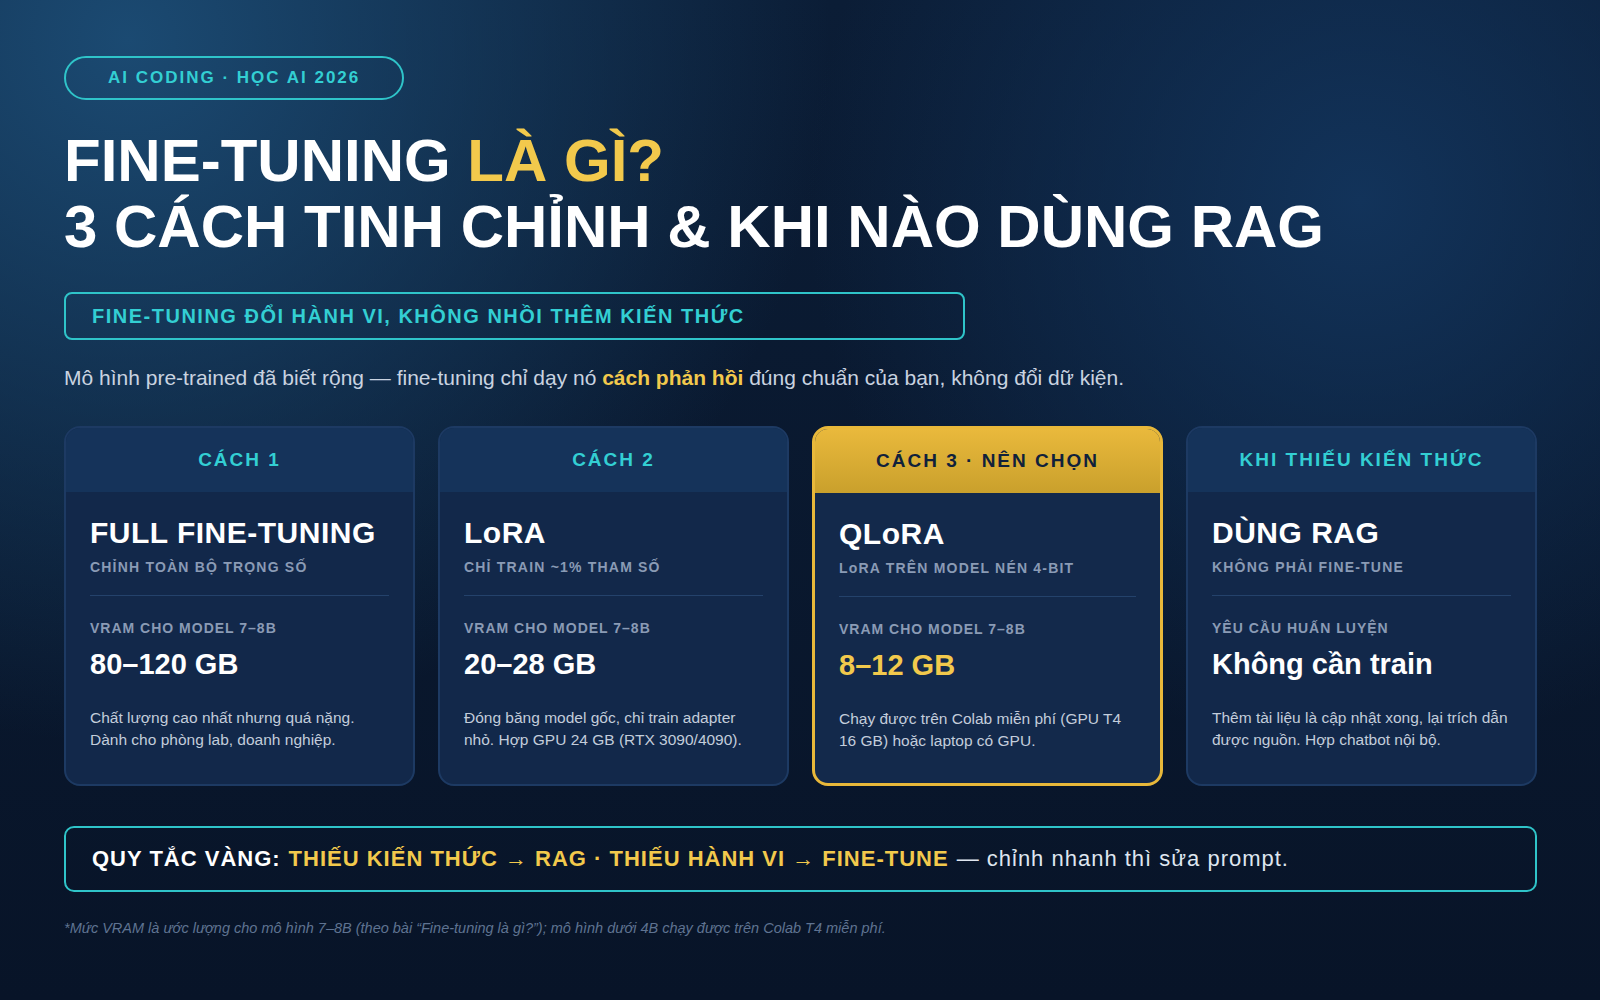
Fine-tuning là gì? Fine-tuning (tinh chỉnh mô hình) là việc huấn luyện thêm một mô hình AI đã pre-trained trên một tập dữ liệu nhỏ và chuyên biệt, nhằm đổi cách mô hình phản hồi — định dạng, giọng điệu, kỹ năng chuyên ngành — mà không train lại từ đầu. Điểm quan trọng nhất: fine-tuning đổi hành vi, chứ không nhồi thêm kiến thức.
Fine-tuning là gì? 3 cách tinh chỉnh & khi nào dùng RAG
Bài này viết cho sinh viên IT và lập trình viên mới. Bạn sẽ hiểu bản chất fine-tuning, biết khi nào nên dùng nó thay prompt hay RAG, và tự chạy được một buổi fine-tune trên Google Colab miễn phí.
Fine-tuning là gì? Giải thích bằng ví dụ đời thường
Hãy hình dung một sinh viên vừa tốt nghiệp ngành IT: biết thuật toán, cấu trúc dữ liệu, vài ngôn ngữ lập trình. Đó là mô hình pre-trained — kiến thức rộng, chưa gắn bối cảnh nào.
Nhưng ngày đầu đi làm, bạn ấy chưa biết công ty viết commit message thế nào. Công ty cho hai tuần onboarding với 200 ví dụ thực tế. Sau đó, bạn ấy làm việc đúng chuẩn. Hai tuần onboarding đó chính là fine-tuning.
Fine-tuning nằm ở đâu trong vòng đời một mô hình
Một LLM đi qua ba chặng:
- Pre-training — đọc lượng văn bản khổng lồ, học dự đoán token tiếp theo.
- Instruction tuning — học trả lời theo hướng dẫn thay vì viết tiếp văn bản.
- Fine-tuning — bạn huấn luyện tiếp trên dữ liệu riêng của mình.
Chỉ chặng thứ ba nằm trong tầm tay sinh viên. Nếu bạn còn mơ hồ về hai chặng đầu, hãy đọc bài LLM là gì trước.
Fine-tuning KHÔNG phải là gì
Đây là phần nhiều người hiểu sai nhất.
- Không phải train from scratch. Train from scratch dựng mô hình từ trọng số ngẫu nhiên, tốn hàng triệu USD.
- Không phải cách dạy kiến thức mới. Fine-tune 500 trang tài liệu nội bộ, mô hình vẫn không “nhớ” nội dung. Nó chỉ học văn phong.
- Không phải prompt dài. Prompt chỉ ảnh hưởng một lần gọi; fine-tuning đổi trọng số nên hiệu ứng là vĩnh viễn.
Có một phép thử rất rõ: sau khi fine-tune, hãy hỏi một sự kiện chỉ có trong dữ liệu huấn luyện. Mô hình thường bịa — hiện tượng gọi là AI hallucination.
Fine-tuning hoạt động như thế nào? Nhìn từ trọng số
Biết fine-tuning là gì mới là một nửa. Nửa còn lại là hiểu nó làm gì với bên trong mô hình.
Mô hình AI thực chất là một tập hợp khổng lồ các con số, gọi là weights (trọng số). Khi fine-tune, bạn đưa vào các cặp “đầu vào — đầu ra mong muốn”. Mô hình dự đoán, so với đáp án, rồi chỉnh nhẹ trọng số để giảm sai số.
Mức chỉnh rất nhỏ. Vì vậy, learning rate quá cao sẽ phá vỡ năng lực gốc của mô hình.
Supervised fine-tuning (SFT) — cách phổ biến nhất
SFT nghĩa là huấn luyện có nhãn: bạn cung cấp sẵn câu hỏi và câu trả lời mẫu, thường ở dạng hội thoại. Đây là phương pháp bạn sẽ dùng 90% thời gian.
RLHF, DPO và RFT — ba cái tên bạn sẽ gặp
- RLHF (Reinforcement Learning from Human Feedback): con người xếp hạng câu trả lời, mô hình học theo thứ hạng.
- DPO (Direct Preference Optimization): đơn giản hơn, chỉ cần cặp “câu tốt — câu kém”.
- RFT (Reinforcement Fine-Tuning): mô hình được thưởng khi đáp án đúng theo hàm chấm điểm. Hợp bài toán kiểm tra được.
Xu hướng 2026 là RFT cho bài toán suy luận. Nhưng với người mới, SFT bằng LoRA là điểm khởi đầu đúng.
Full fine-tuning, LoRA và QLoRA: chọn cách nào cho máy của bạn?
Đây là lúc câu hỏi thực tế xuất hiện: laptop của tôi có fine-tune được không?
Full fine-tuning: chỉnh toàn bộ trọng số
Cách này cập nhật mọi tham số. Chất lượng cao nhất, nhưng bạn phải giữ trong VRAM cả trọng số, gradient và trạng thái optimizer. Với mô hình 7–8B, con số thực tế thường là 80–120 GB VRAM. Sinh viên nên bỏ qua vì không phù hợp.
LoRA là gì? Chỉ train khoảng 1% tham số
LoRA (Low-Rank Adaptation) đóng băng toàn bộ mô hình gốc. Nó chèn thêm hai ma trận nhỏ vào từng lớp và chỉ huấn luyện hai ma trận đó.
Hãy hình dung mô hình gốc là một cuốn sách in. LoRA không in lại sách; nó chỉ dán giấy nhớ vào trang cần sửa. Tập giấy nhớ đó gọi là adapter, thường vài chục MB.
Ba tham số bạn cần biết:
- r (rank): độ “dày” của adapter. Giá trị 8–32 là hợp lý.
- alpha: hệ số nhân mức ảnh hưởng của adapter. Thường bằng r hoặc gấp đôi r.
- target modules: các lớp được gắn adapter, phổ biến là lớp attention và MLP.
LoRA thuộc nhóm PEFT (Parameter-Efficient Fine-Tuning) — tinh chỉnh tiết kiệm tham số.
QLoRA: nén mô hình xuống 4-bit rồi mới train
QLoRA thêm một bước: nạp mô hình gốc ở dạng lượng tử hóa 4-bit, rồi train adapter LoRA trên nền đó. Bộ nhớ giảm khoảng ba đến bốn lần.
Nhờ vậy, GPU 16 GB miễn phí trên Colab đủ sức fine-tune mô hình cỡ vừa. Theo tài liệu Unsloth, Qwen3 bản 14B vừa khít GPU Tesla T4 của Colab.
| Phương pháp | VRAM cho model 7–8B | Chất lượng | Phù hợp với ai |
|---|---|---|---|
| Full fine-tuning | 80–120 GB | Cao nhất | Phòng lab, doanh nghiệp |
| LoRA (16-bit) | 20–28 GB | Rất tốt | GPU 24 GB (RTX 3090/4090) |
| QLoRA (4-bit) | 8–12 GB | Tốt | Colab miễn phí, laptop có GPU |
Với mô hình nhỏ hơn, VRAM giảm nhanh: khoảng 3 GB cho mô hình dưới 1B, 5 GB cho 2B, 10 GB cho 4B (ước lượng).
Khi nào nên fine-tune, khi nào dùng prompt hay RAG?
Hiểu fine-tuning là gì vẫn chưa đủ. Bạn còn phải biết khi nào không nên dùng nó. Hãy trả lời câu hỏi này trước khi viết dòng code đầu tiên, vì đa số dự án không cần fine-tuning.
Quy tắc ba dòng, dễ nhớ:
- Thiếu kiến thức (tài liệu riêng, dữ liệu mới) → dùng RAG.
- Thiếu hành vi (định dạng sai, giọng không đúng, không theo quy ước) → fine-tune.
- Chỉ cần chỉnh nhanh → sửa prompt.
Bảng so sánh fine-tuning và RAG
| Tiêu chí | Fine-tuning | RAG |
|---|---|---|
| Giải quyết | Hành vi, định dạng, giọng | Kiến thức, dữ liệu riêng |
| Cập nhật dữ liệu | Phải train lại | Chỉ cần thêm tài liệu |
| Chi phí ban đầu | Trung bình đến cao | Thấp |
| Chi phí mỗi lần gọi | Thấp (prompt ngắn) | Cao hơn (prompt dài) |
| Trích dẫn nguồn | Không | Có |
Hai kỹ thuật này không loại trừ nhau. Hệ thống thật thường fine-tune để cố định định dạng, rồi dùng RAG để cấp dữ kiện. Chi tiết kiến trúc, xem bài RAG là gì.
Thứ tự thử đúng trong năm 2026
Hãy đi theo thứ tự tăng dần chi phí: prompt tốt hơn → thêm RAG → fine-tune mô hình open-weight bằng LoRA → cuối cùng mới tính tới API fine-tuning.
Muốn học LLM, RAG và fine-tuning trong một lộ trình có mentor chấm bài và review code? Tham khảo khóa học AI Coding tại CodeGym Đà Nẵng.
Cập nhật 2026: API fine-tuning của các hãng đang thay đổi ra sao
Định nghĩa fine-tuning là gì thì không đổi, nhưng cách fine-tune qua API thương mại đang đổi rất nhanh. Hầu hết bài tiếng Việt chưa cập nhật phần này, nên đọc hướng dẫn cũ rồi mở tài liệu OpenAI là bối rối.
OpenAI đang ngừng dần fine-tuning tự phục vụ
Ngày 7/5/2026, OpenAI công bố lộ trình khai tử self-serve fine-tuning. Theo trang deprecations của OpenAI, mốc thời gian như sau:
- 07/05/2026: tổ chức mới không còn được tạo job fine-tuning.
- 02/07/2026: chỉ tổ chức có hoạt động inference trong 60 ngày gần nhất được tạo job.
- 06/01/2027: khách hàng hiện hữu cũng không tạo được job mới.
Inference trên mô hình đã fine-tune vẫn chạy, cho tới khi mô hình nền bị khai tử. Lý do OpenAI nêu ra: mô hình nền mới tuân thủ hướng dẫn và định dạng tốt hơn, nên cách làm bằng prompt đã rẻ và nhanh hơn.
Các hãng khác thì sao
- Google Vertex AI vẫn cung cấp supervised tuning cho dòng Gemini, tính giá theo token huấn luyện.
- Anthropic không mở fine-tuning trên API gốc; Claude chỉ fine-tune được qua Amazon Bedrock với một số phiên bản nhất định.
- Mistral, Together AI, Fireworks nhận fine-tune mô hình open-weight, tính tiền theo token.
Fine-tuning là gì với người học năm 2026?
Kỹ năng đáng đầu tư không phải “biết gọi API fine-tune”. Thị trường cần người biết chạy LoRA trên mô hình open-weight, chuẩn bị dữ liệu và đánh giá kết quả.
Hướng dẫn tự fine-tune một LLM nhỏ bằng Python trên Google Colab
Phần này đi từ bước cơ bản nhất. Bạn chỉ cần đọc được vòng lặp và hàm Python.
Bước 0 — Chuẩn bị môi trường
Bạn cần tài khoản Google để dùng Colab, tài khoản Hugging Face miễn phí, và khoảng 40 phút. Trong Colab, chọn Runtime → Change runtime type → T4 GPU. Không bật GPU thì mọi bước sau thất bại.
Bước 1 — Cài thư viện
pip install --upgrade --no-cache-dir unsloth unsloth_zoo
pip install -q trl peft datasets bitsandbytes accelerate
Giải thích nhanh từng thư viện:
- unsloth: tối ưu tốc độ và bộ nhớ, giúp vừa GPU miễn phí.
- trl: cung cấp
SFTTrainer, lớp huấn luyện có nhãn. - peft: hiện thực LoRA và các phương pháp tiết kiệm tham số.
- datasets: nạp và xử lý dữ liệu.
- bitsandbytes: lượng tử hóa 4-bit cho QLoRA.
Hệ sinh thái này đổi phiên bản rất nhanh. Nếu gặp lỗi import, hãy đối chiếu notebook chính thức của Unsloth.
Bước 2 — Nạp mô hình nhỏ ở dạng 4-bit
from unsloth import FastLanguageModel

model, tokenizer = FastLanguageModel.from_pretrained(
    model_name="unsloth/Qwen3-4B-Instruct",  # hoặc Llama-3.2-3B-Instruct
    max_seq_length=2048,
    load_in_4bit=True,       # bật QLoRA
)
Vì sao chọn mô hình nhỏ? Bạn đang học quy trình, không đua chất lượng. Mô hình 3–4B train xong trong 15 phút.
Bước 3 — Chuẩn bị dữ liệu
Hãy tạo file JSONL khoảng 100–300 mẫu, mỗi dòng một hội thoại. Ví dụ bài toán “chuyển câu tiếng Việt thành SQL”:
{"messages": [{"role": "user", "content": "Liệt kê 5 sinh viên điểm cao nhất"}, {"role": "assistant", "content": "SELECT ho_ten, diem FROM sinh_vien ORDER BY diem DESC LIMIT 5;"}]}Chất lượng quan trọng hơn số lượng: 150 mẫu sạch và nhất quán cho kết quả tốt hơn 2.000 mẫu lẫn lộn.
from datasets import load_dataset

ds = load_dataset("json", data_files="data.jsonl", split="train")

def to_text(row):
    return {"text": tokenizer.apply_chat_template(
        row["messages"], tokenize=False, add_generation_prompt=False)}

ds = ds.map(to_text)
Hàm apply_chat_template chuyển hội thoại sang đúng định dạng mô hình đã quen. Bỏ bước này là nguyên nhân thất bại phổ biến nhất.
Bước 4 — Cấu hình LoRA
model = FastLanguageModel.get_peft_model(
    model,
    r=16,
    lora_alpha=16,
    lora_dropout=0,
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj",
                    "gate_proj", "up_proj", "down_proj"],
)
r=16 là mức cân bằng tốt. Tăng r giúp học thay đổi phức tạp hơn, nhưng dễ overfitting khi dữ liệu ít.
Bước 5 — Huấn luyện
from trl import SFTTrainer, SFTConfig

trainer = SFTTrainer(
    model=model,
    train_dataset=ds,
    args=SFTConfig(
        per_device_train_batch_size=2,
        gradient_accumulation_steps=4,
        max_steps=80,
        learning_rate=2e-4,
        logging_steps=5,
        output_dir="outputs",
    ),
)
trainer.train()
Hãy theo dõi cột loss trong log. Loss giảm đều là tốt. Loss đứng im nghĩa là learning rate quá thấp hoặc dữ liệu sai định dạng. Loss về gần 0 quá nhanh là mô hình học vẹt.
Bước 6 — Kiểm thử trước và sau
Đây là bước nhiều người bỏ qua, nhưng quan trọng nhất. Hãy chuẩn bị 5 prompt, chạy trước và sau khi train.
Ngoài ra, hãy thêm một câu hỏi về kiến thức chỉ có trong dữ liệu huấn luyện. Mô hình gần như chắc chắn trả lời sai — bằng chứng fine-tuning đổi hành vi, không thêm kiến thức.
Bước 7 — Xuất model và chạy bằng Ollama
model.save_pretrained_gguf("qwen3-sql", tokenizer, quantization_method="q4_k_m")Sau đó tải file GGUF về máy, viết một Modelfile trỏ tới file đó, rồi chạy ollama create và ollama run. Mô hình bạn tự huấn luyện giờ chạy offline.
Lỗi thường gặp
- CUDA out of memory: giảm
max_seq_length, giảm batch size, hoặc chọn mô hình nhỏ hơn. - Loss không giảm: kiểm tra chat template và định dạng JSONL trước tiên.
- Catastrophic forgetting: mô hình giỏi việc mới nhưng quên năng lực cũ. Hãy giảm epoch, giảm learning rate và giữ một tập eval có cả câu hỏi ngoài phạm vi huấn luyện.
Fine-tuning cần bao nhiêu dữ liệu và tốn bao nhiêu tiền?
Về dữ liệu. Đổi định dạng hoặc giọng điệu: vài trăm mẫu sạch là đủ. Dạy quy ước code của team: khoảng 500–1.000 mẫu. Chuyển sang một lĩnh vực hẹp: 5.000–10.000 mẫu trở lên.
Về giá. Với mô hình dưới 4B, Colab miễn phí là đủ. Thuê GPU thường ở mức vài chục xu đến khoảng 1 USD mỗi giờ. Chi phí thật nằm ở chỗ khác: làm sạch dữ liệu, dựng bộ eval, và train lại mỗi khi mô hình nền ra bản mới.
Với doanh nghiệp. Nếu bạn đang được tư vấn “fine-tune AI cho công ty”, hãy hỏi lại: vấn đề là thiếu kiến thức hay thiếu hành vi? Nếu là kiến thức, RAG rẻ hơn nhiều.
Fine-tuning nằm ở bước nào trong lộ trình AI Engineer?
Thứ tự hợp lý: dùng API thành thạo → prompt engineering → RAG → fine-tuning → eval. Một notebook fine-tune có kết quả trước–sau rõ ràng là dự án portfolio đáng giá. Xem thêm lộ trình học AI cho người mới.
Câu hỏi thường gặp về fine-tuning
Fine-tuning khác gì với training model từ đầu?
Training from scratch bắt đầu từ trọng số ngẫu nhiên, cần hàng nghìn tỷ token và chi phí hàng triệu USD. Fine-tuning bắt đầu từ mô hình đã pre-trained, chỉ cần vài trăm đến vài nghìn mẫu. Nói ngắn gọn: một bên là xây nhà mới, bên kia là sửa nội thất.
Fine-tuning có dạy được kiến thức mới cho AI không?
Về cơ bản là không, hoặc rất kém hiệu quả. Fine-tuning thay đổi cách mô hình phản hồi: định dạng, giọng điệu, cấu trúc câu trả lời. Muốn mô hình trả lời đúng theo tài liệu riêng, hãy dùng RAG. Đây là nhầm lẫn phổ biến nhất của người mới.
LoRA có phải là fine-tuning không?
Có. LoRA là một dạng fine-tuning tiết kiệm tham số, thuộc nhóm PEFT. Nó đóng băng mô hình gốc và chỉ huấn luyện hai ma trận nhỏ chèn thêm, khoảng 1% tổng tham số. Kết quả rất gần full fine-tuning, nhưng chi phí bộ nhớ thấp hơn nhiều lần.
Laptop không có GPU có fine-tune được không?
Không nên thử trên CPU, vì thời gian train tính bằng ngày. Giải pháp miễn phí là Google Colab với GPU T4 16 GB. Với QLoRA, bạn fine-tune được mô hình 3–4B khá thoải mái; tài liệu Unsloth cho biết mô hình 14B cũng vừa trên T4.
Fine-tuning cần bao nhiêu dữ liệu là đủ?
Tùy mục tiêu. Đổi định dạng hoặc giọng điệu chỉ cần vài trăm mẫu sạch, nhất quán. Dạy quy ước code của một đội cần 500–1.000 mẫu. Chuyển sang lĩnh vực hẹp cần 5.000–10.000 mẫu trở lên. Chất lượng luôn quan trọng hơn số lượng.
OpenAI có còn cho fine-tuning năm 2026 không?
Đang ngừng dần. Từ 7/5/2026, tổ chức mới không tạo được job fine-tuning. Từ 6/1/2027, khách hàng hiện hữu cũng không tạo được job mới. Inference trên mô hình đã fine-tune vẫn chạy đến khi mô hình nền bị khai tử. Vì vậy hãy học LoRA trên mô hình mở.
Nên fine-tune hay dùng RAG cho chatbot nội bộ công ty?
Gần như luôn là RAG. Chatbot nội bộ cần trả lời đúng theo tài liệu, quy trình và số liệu — đó là bài toán kiến thức. RAG cho phép cập nhật tài liệu mà không train lại và trích dẫn được nguồn. Chỉ fine-tune thêm khi muốn cố định định dạng.
Fine-tune model tiếng Việt thì chọn model nào?
Hãy chọn mô hình open-weight đa ngôn ngữ có bản nhỏ, ví dụ dòng Qwen hoặc Gemma, rồi tự đo trên dữ liệu của bạn. Lưu ý tiếng Việt có dấu tốn nhiều token hơn tiếng Anh, nên tăng max_seq_length. Quan trọng nhất là dựng 20–30 câu hỏi thật để so sánh.
Kết luận: Fine-tuning là gì và bắt đầu từ đâu
Ba ý cần mang theo. Thứ nhất, fine-tuning đổi hành vi, không thêm kiến thức — thiếu kiến thức thì dùng RAG. Thứ hai, kỹ năng đáng học năm 2026 là LoRA trên mô hình open-weight. Thứ ba, Colab miễn phí là đủ để bắt đầu.
Bước tiếp theo: mở Colab, tạo 100 mẫu JSONL cho một bài toán nhỏ của bạn, rồi chạy lại các bước trên.
CTA cuối bài: Muốn học AI Coding bài bản — từ prompt engineering, RAG đến fine-tuning — với mentor là lập trình viên đang đi làm? Xem lộ trình khóa học AI Coding tại CodeGym Đà Nẵng hoặc để lại thông tin để được tư vấn miễn phí.
0 Lời bình